Quand les opérateurs ne font pas confiance aux données : faire adopter l'IoT en atelier
DBR77 Team · Publié le
Les opérateurs commencent à croire les données IoT quand elles correspondent à ce qu'ils voient à la machine, quand leur saisie change visiblement quelque chose et quand les chiffres servent à les aider. S'il manque un seul de ces points, ils ignorent l'écran, choisissent « autre » comme cause d'arrêt et gardent leur propre carnet.
La méfiance des premières semaines est normale, et elle est utile. Elle désigne généralement un vrai problème dans les données ou dans leur usage. Cet article montre comment trouver ce problème et le corriger.
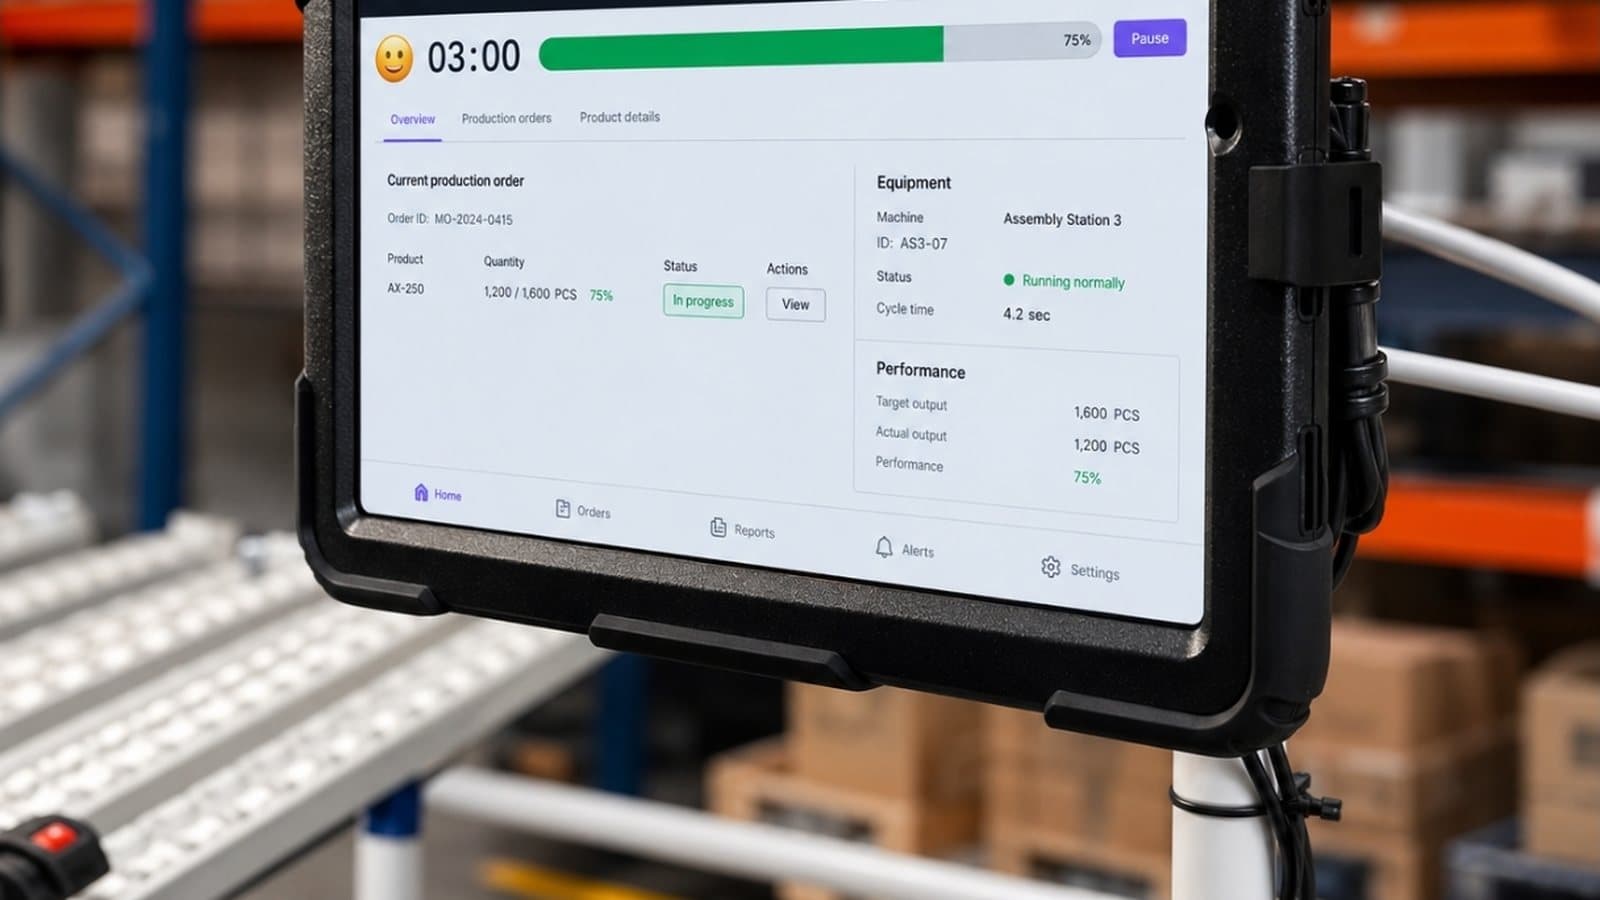
Pourquoi les opérateurs se méfient des signaux machines
Sur une ligne existante typique, la méfiance a quelques origines. Chacune a une cause que l'on peut corriger.
| Ce que dit l'opérateur | Ce qu'il y a derrière | Que faire |
|---|---|---|
| « L'écran dit qu'on était à l'arrêt, mais on tournait. » | Logique d'états fausse, par exemple une pause comptée comme arrêt | Valider les états avec les opérateurs avant de publier des chiffres |
| « Aucune cause ne correspond à ce qui s'est passé. » | Liste de causes rédigée au bureau ou copiée de l'ERP | Réécrire la liste avec les opérateurs, avec leurs mots |
| « C'est juste pour nous surveiller. » | Données affichées par personne ou utilisées lors d'un entretien disciplinaire | Fixer par écrit à quoi servent les données ; présenter par ligne et par équipe |
| « On l'a déjà dit, rien ne bouge. » | Les remontées disparaissent et personne ne donne de retour | Montrer chaque correction issue d'une remontée des opérateurs |
Un déploiement IoT est un projet de changement, et c'est l'atelier qui décide s'il réussit. Prosci a constaté que les projets dotés d'une excellente conduite du changement avaient environ sept fois plus de chances d'atteindre leurs objectifs que ceux dont la conduite du changement était faible.
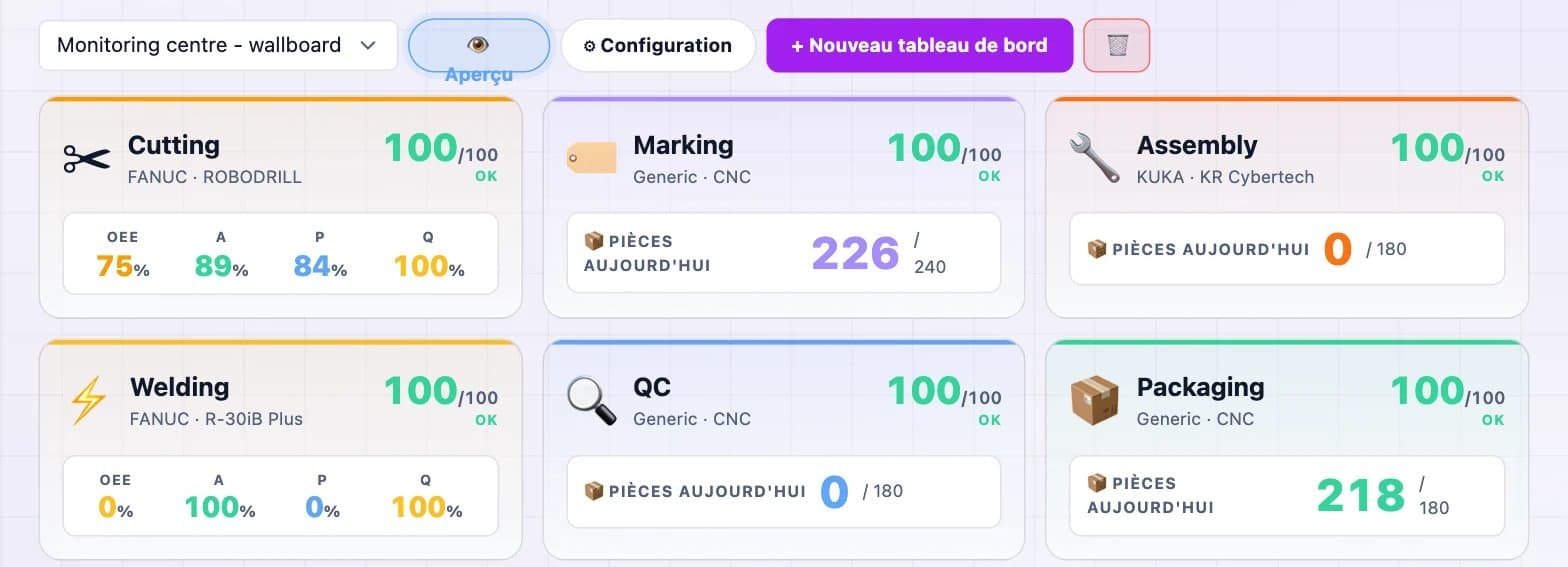
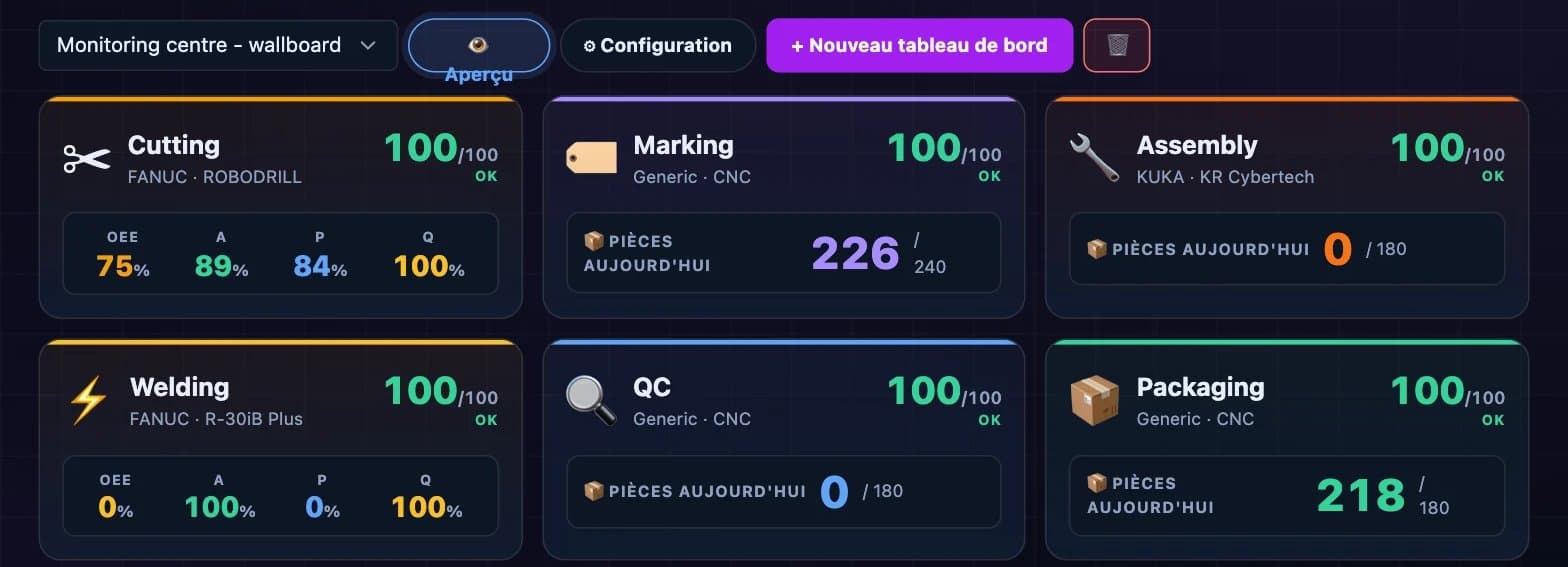
Corriger les données avant de demander la confiance
Des chiffres faux brûlent une crédibilité dont vous aurez besoin plus tard : corrigez donc le signal avant de publier quoi que ce soit.
Une machine est comptée « en production » parce que le courant moteur dépasse un seuil, alors qu'elle tourne à vide sans matière. Un changement de série apparaît comme un arrêt non planifié. Les cycles lents restent invisibles parce que seule la colonne lumineuse est lue.
Par exemple, le système affiche 40 minutes d'arrêt sur une presse alors que l'opérateur se souvient de 15. La différence est une pause de 25 minutes que personne n'a saisie dans le calendrier des équipes (chiffres indicatifs). Un seul chiffre faux de ce type sur un tableau suffit à faire paraître tout le système peu fiable.
Une courte routine de validation évite cela :
- Faire tourner le système une à deux semaines sans publier de chiffres.
- À chaque poste, l'opérateur et le chef d'équipe comparent la chronologie machine avec ce qui s'est réellement passé.
- Chaque écart devient une correction : un seuil, une entrée de calendrier, un signal manquant.
- Ne publier que lorsque les opérateurs reconnaissent leur poste dans la chronologie.
Notre article sur pourquoi les données machines sont inutiles sans contexte explique quel contexte ajouter.
Voir ce que voient les opérateurs
En 30 minutes de démo en ligne, nous montrons l'écran opérateur, la saisie des causes au moment de l'arrêt et comment le responsable de ligne modifie les listes de causes sans passer par l'informatique.
Laisser les opérateurs écrire la liste des causes
Des causes d'arrêt rédigées au bureau correspondent rarement à l'atelier. Les opérateurs choisissent alors « autre » ou la première ligne, et le Pareto se remplit de bruit.
Asseyez-vous une heure avec deux ou trois opérateurs par type de machine et demandez-leur ce qui arrête vraiment la machine. Gardez 10 à 15 causes, avec leurs mots. « Attente du cariste » fonctionne mieux que « Retard logistique interne ».
Cela se vérifie aussi en dehors de l'IoT. Dans un projet de passation de poste décrit par The Keil Centre, les utilisateurs des nouveaux registres les ont conçus avec l'équipe projet, et l'auteur attribue à cette implication le succès du dispositif (Lardner, 1999).
Revoyez la liste chaque mois. Si « autre » dépasse environ 10 % du temps d'arrêt, une cause manque. Dans l'application opérateur DBR77 IIoT, le responsable de ligne modifie la liste sans ticket à l'informatique.
Montrer aux opérateurs les gains issus de leurs propres saisies
Les opérateurs font confiance au système bien plus tôt quand ils voient leur propre saisie aboutir à une correction, et ils cessent de saisir quand leurs remontées disparaissent.
Prenons une situation typique. Sur une ligne de conditionnement, les opérateurs marquent sans cesse des arrêts courts « bourrage film ». Au bout de trois semaines, les données montrent que c'est la plus grosse perte de la ligne en minutes, alors que chaque arrêt dure moins de deux minutes. Vorne note que la plupart des entreprises ne mesurent pas précisément ces petits arrêts. La maintenance modifie le guide-film et les arrêts chutent (exemple indicatif).
Ensuite, dites-le à l'équipe. Affichez-le sur le tableau de la ligne : « Vous avez saisi "bourrage film" 140 fois en trois semaines. Le guide a été changé mardi. Voici la courbe depuis. » Les opérateurs comprennent que leurs deux secondes au moment de l'arrêt en valaient la peine. Toyota le dit simplement : les machines s'arrêtent en cas d'anomalie, mais « seuls les humains peuvent mettre en œuvre le kaizen ».
Analyser les contournements des opérateurs
Tôt ou tard, les opérateurs passent outre le système. Ils changent une cause après coup, déclarent un arrêt comme planifié ou acquittent une alerte sans agir. Le premier réflexe est de parler de triche, et ce réflexe se trompe généralement.
Un contournement est une information sur une règle qui ne colle pas au processus réel. Le Health and Safety Executive britannique note que les écarts volontaires aux procédures se produisent souvent lorsque la tâche a été mal conçue, et privilégie comme remède la reconception de la tâche ou de l'équipement.
Analysez les contournements chaque semaine avec les chefs d'équipe :
- Regroupez-les par règle. Dix contournements d'un même seuil d'alerte forment un seul constat.
- Demandez pourquoi à l'opérateur. La réponse est souvent simple : l'alerte se déclenche pendant le nettoyage planifié, ou un cas fréquent n'est pas prévu.
- Changez la règle ou expliquez-la. Si elle est fausse, modifiez-la et annoncez-le à la prochaine prise de poste.
- Suivez le taux de contournement. Il doit baisser avec le temps.
Les alertes trop bruyantes sont un déclencheur fréquent ; voir pourquoi les alertes IIoT échouent en atelier.
Utiliser les données pour aider, pas pour sanctionner
Le moyen le plus rapide de perdre l'atelier est d'utiliser le premier mois de données dans un entretien disciplinaire. Ensuite, les causes deviennent plus vagues et les contournements augmentent.
Les gens changent aussi de comportement quand ils se savent mesurés. Une revue systématique du Journal of Clinical Epidemiology a conclu que le fait d'être étudié influence bien le comportement étudié. Des opérateurs qui se sentent surveillés feront dire aux données ce qu'ils veulent montrer.
Fixez quelques règles par écrit avant le démarrage : les données sont analysées par ligne et par équipe, sans classement individuel ; un arrêt amène une question sur le processus ; les opérateurs voient les mêmes écrans que les managers ; les représentants du personnel voient les règles en premier.
Questions fréquentes
Combien de temps faut-il pour que les opérateurs fassent confiance aux données IoT ?
Comptez quatre à huit semaines sur une ligne. La confiance vient d'une chronologie qui correspond à leur poste et d'au moins une correction visible issue de leurs remontées.
Faut-il autoriser les opérateurs à modifier une cause d'arrêt après coup ?
Oui, pendant le même poste et avec une trace de la modification. Bloquer les corrections pousse vers « autre ». Les modifications tracées montrent où la liste de causes ou la logique d'états est fragile.
Faut-il afficher l'OEE par opérateur ?
Nous le déconseillons les premiers mois. La performance dépend autant de la matière, de la maintenance et de la planification que de la personne.
Que faire si une équipe continue de rejeter le système ?
Passez un poste avec elle. En général, elle a trouvé un vrai défaut dans les données, ou des chiffres ont été utilisés contre elle. Corrigez cela d'abord.
Conclusion
Comptez quatre à huit semaines avant que les opérateurs d'une ligne fassent confiance aux chiffres ; l'essentiel de ce temps sert à rendre la chronologie juste. Choisissez une ligne et faites tourner le système une à deux semaines sans rien publier. À la fin de chaque poste, l'opérateur et le chef d'équipe comparent la chronologie machine avec ce qui s'est passé, et chaque écart devient une correction de seuil, de calendrier ou de signal avant que le premier chiffre n'arrive sur un tableau.
Préparer un pilote que l'atelier acceptera
Nous mettons en place avec vous des semaines de validation, des listes de causes écrites par les opérateurs et une revue des contournements avant qu'un seul chiffre n'apparaisse sur un tableau.
Sources
- Prosci, The Correlation Between Change Management and Project Success, 2023
- The Keil Centre (R. Lardner), Safe Communication at Shift Handover: Setting and Implementing Standards, 1999
- Vorne, The Six Big Losses
- Toyota Motor Corporation, Toyota Production System
- Health and Safety Executive (Royaume-Uni), Managing human failures, 2024
- McCambridge J., Witton J., Elbourne D., Systematic review of the Hawthorne effect, Journal of Clinical Epidemiology, 2014