Pourquoi les alertes machine échouent en atelier : fausses alarmes, escalade et délai de réaction
DBR77 Team · Publié le
Les alertes machine échouent en atelier quand il y en a trop, quand elles sont envoyées à un groupe plutôt qu'à une personne, et quand personne ne suit ce qui se passe après leur déclenchement. Elles fonctionnent quand chaque alerte correspond à un événement réel, devient une tâche avec un seul responsable et escalade selon une règle écrite.
Sur une ligne de conditionnement de carton ondulé, ce changement a fait passer le délai moyen de prise en charge d'un arrêt de 24 à 9 minutes en réduisant l'écart entre l'arrêt et la réaction.
Où partaient les 24 minutes
Avant le changement, un arrêt suivait un parcours bien connu. Quand la machine s'arrêtait, quelqu'un le remarquait tôt ou tard et allait chercher le chef d'équipe, qui appelait la maintenance par radio. Il fallait ensuite que la maintenance découvre ce qui s'était arrêté, et où.
L'essentiel de ce temps s'écoulait avant que quiconque sache que la machine était arrêtée. Après le changement :
- L'arrêt devient une alerte au moment où il se produit.
- L'alerte devient une tâche avec un responsable du poste en cours, avec la machine, l'heure et la cause associées.
- La réaction est suivie dans le système : heure de prise en charge, début de l'intervention, redémarrage de la machine.
Les 15 minutes gagnées venaient du fait que l'arrêt était connu plus tôt, la réparation elle-même durant autant qu'avant. Mieux vaut donc concentrer l'effort sur le délai entre un arrêt et le moment où la bonne personne en est informée. Le pilote est décrit plus en détail dans Réduire les arrêts de production grâce aux données en temps réel.
Pourquoi les alertes sont ignorées
Les usines qui activent les alertes machine récoltent souvent du bruit. Les téléphones vibrent pendant tout le poste, la plupart des alertes ne demandent aucune action, et au bout d'une semaine les gens ne regardent plus.
Les salles de contrôle de l'industrie de process ont compris ce problème depuis longtemps. L'Energy Institute définit une alarme comme un signal qui indique un problème nécessitant l'attention et la réaction de l'opérateur. Sa note de synthèse cite la recommandation de l'EEMUA d'environ une alarme toutes les 10 minutes en moyenne, ainsi que le cas d'une pétrochimie où les opérateurs en recevaient une par minute.
Les normes de gestion des alarmes formalisent cette approche. ANSI/ISA-18.2 encadre les alarmes sur tout leur cycle de vie, de la philosophie et de la rationalisation jusqu'à la surveillance et l'audit. L'ISA publie aussi un rapport technique pour les procédés discontinus et discrets visant à réduire les alarmes parasites. EEMUA 191 est l'autre guide largement utilisé. Le même principe vaut en atelier : une alerte qui n'exige aucune action doit être supprimée.
Problèmes courants d'alertes et corrections
La plupart des défaillances d'alertes sur une ligne discrète ont peu de causes. Les seuils ci-dessous sont des points de départ indicatifs, à ajuster selon vos machines.
| Problème d'alerte | Cause | Correction |
|---|---|---|
| Alertes pour des arrêts qui se sont résorbés tout seuls | Aucune durée minimale d'arrêt | Temporisation : n'alerter que si l'arrêt dure plus de, par exemple, 2 minutes |
| Même arrêt alerté en boucle | Le signal oscille entre marche et arrêt | Durée de maintien avant qu'un nouvel état puisse être pris en compte |
| Cinq alertes pour un seul problème | Un arrêt en amont prive de matière ou bloque le reste de la ligne | Regrouper les alertes par ligne et ne remonter que l'arrêt racine |
| Alertes pendant les pauses et les changements de série | Les arrêts planifiés ne sont pas dans le système | Un calendrier de poste et des arrêts planifiés qui suspendent les alertes |
| Alerte que personne ne lit | Envoyée à un groupe ou à un écran partagé | Un seul responsable, désigné par son rôle, sur le poste en cours |
| Le responsable arrive sans savoir ce qu'il doit apporter | L'alerte indique seulement « machine arrêtée » | Machine, emplacement, durée et cause donnée par l'opérateur dans l'alerte |
Les arrêts courts demandent une attention particulière. Vorne décrit les micro-arrêts comme des arrêts de bien moins de cinq minutes qui ne nécessitent pas d'intervention de maintenance. Comptez-les et passez-les en revue chaque jour, sans appeler un technicien pour chacun d'eux.
Voyez comment une alerte devient une tâche avec un responsable
Lors d'une démonstration de 30 minutes, nous montrons les arrêts en direct, la saisie des causes, le routage des alertes et l'escalade dans DBR77 IIoT, sur une configuration de ligne réelle.
Des règles d'escalade qui fonctionnent
Sans règle d'escalade, une alerte non acquittée reste simplement en attente. Voici un jeu de départ réaliste (valeurs indicatives) :
- Non acquittée au bout de 5 minutes : le chef d'équipe reçoit l'alerte.
- Acquittée mais machine toujours à l'arrêt après 20 minutes : le responsable maintenance est informé.
- Machine goulot à l'arrêt plus de 30 minutes : le directeur de production est informé, car le plan du poste est menacé.
- Même cause d'arrêt trois fois dans un même poste : une tâche de suivi est créée pour la revue du lendemain.
Escaladez vers un superviseur lorsqu'une décision est nécessaire et que le responsable ne peut pas la prendre seul : déplacer du personnel, modifier le plan, faire appel à un prestataire extérieur. Tant que le responsable traite le problème dans le délai normal de réparation, l'escalade est inutile. Rédigez les règles avant la mise en service.
Faire de chaque alerte une tâche
Contrairement à une notification, qui signale seulement qu'un événement s'est produit, une tâche a un responsable, un statut et une heure de clôture. Sur la ligne de conditionnement, c'est la transformation des alertes en tâches qui a fait baisser le délai de réaction.
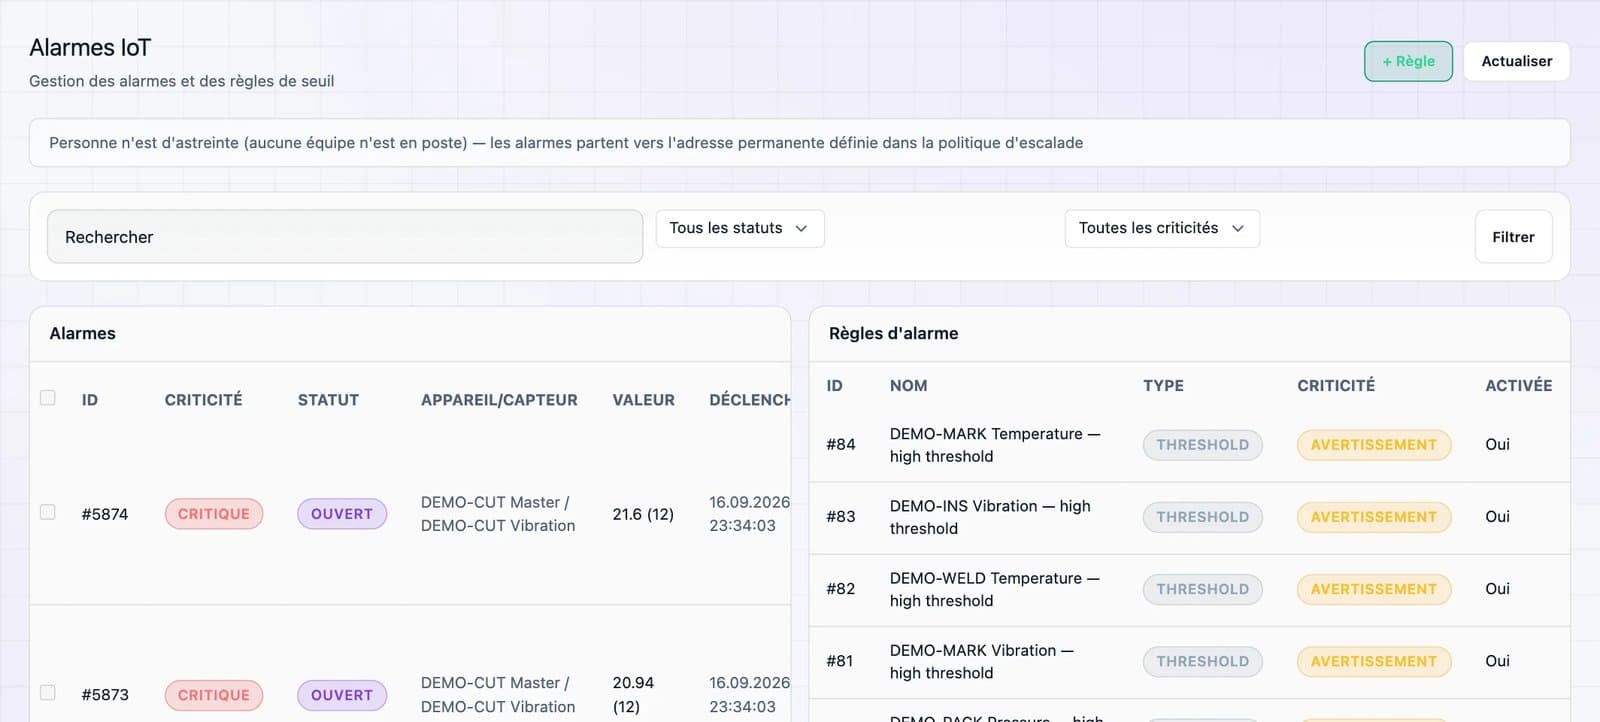
Dans DBR77 IIoT, l'opérateur choisit la cause de l'arrêt sur la machine en environ deux secondes, et l'alerte parvient au responsable sous forme de tâche dans l'application opérateur. La prise en charge et la clôture sont horodatées. Pour les usines qui veulent aller plus loin, IRIS boucle le processus de la détection jusqu'à l'action assignée et au suivi.
Les alertes ont aussi besoin de contexte : un arrêt pendant un changement de série n'a pas le même sens qu'un arrêt en pleine production. Notre article sur les raisons pour lesquelles les données machines sont inutiles sans contexte traite ce point. Si vous utilisez déjà une GMAO, vous déciderez plus tard si les alertes doivent créer des ordres de travail dans cet outil ; voir quand intégrer l'IoT au MES, à l'ERP et à la GMAO.
Comment savoir si vos alertes fonctionnent
Passez ces indicateurs en revue chaque semaine avec les chefs d'équipe :
- Alertes par responsable et par poste. Si une personne en reçoit des dizaines, les seuils ou le regroupement doivent être revus.
- Part des alertes acquittées dans les 5 minutes. Une baisse est le premier signe de fatigue.
- Délai moyen de prise en charge d'un arrêt. C'est le résultat ; les trois autres indicateurs l'expliquent.
- Alertes clôturées sans action. Chacune est un candidat à la suppression.
Siemens estime que les 500 plus grandes entreprises mondiales perdent environ 11 % de leur chiffre d'affaires annuel à cause des arrêts non planifiés, et les minutes qui séparent un arrêt du moment où la bonne personne en est informée sont la part de cette perte la moins coûteuse à supprimer.
Questions fréquentes
Combien d'alertes par poste, c'est trop ?
Il n'existe pas de chiffre unique pour l'atelier. Les recommandations des salles de contrôle retiennent environ une alarme toutes les 10 minutes comme repère. Si un responsable reçoit des alertes plus vite qu'il ne peut agir, revoyez d'abord les seuils et le regroupement.
Quelle durée minimale d'arrêt doit déclencher une alerte ?
Partez de 1 à 3 minutes, selon les micro-arrêts normaux de la machine. Les arrêts plus courts doivent quand même être enregistrés et revus chaque jour, sans appeler personne.
Faut-il envoyer les alertes dans un groupe de discussion ou sur un écran partagé ?
C'est acceptable pour la visibilité. Mais la responsabilité est autre chose : chaque alerte doit avoir un seul responsable nommé sur le poste en cours, sinon chacun suppose que quelqu'un d'autre s'en occupe.
Les opérateurs doivent-ils saisir une cause pour chaque arrêt ?
Pour les arrêts au-delà du seuil d'alerte, oui. Cela prend environ deux secondes et vaut mieux que des notes rédigées en fin de poste.
Les alertes peuvent-elles fonctionner sans connexion à notre GMAO ?
Oui. Des alertes transformées en tâches avec des responsables apportent à elles seules le gain sur le délai de réaction. L'intégration à la GMAO peut venir plus tard.
Conclusion
Avant d'ajouter de nouvelles alertes, choisissez une ligne et passez en revue avec les chefs d'équipe une semaine d'alertes à l'aide des quatre indicateurs ci-dessus. Les alertes clôturées sans action montrent où il manque une durée minimale d'arrêt ou un regroupement. Corrigez d'abord ces points, puis rédigez les règles d'escalade pour les alertes restantes.
Mettez en place des alertes auxquelles vos chefs d'équipe feront confiance
Réservez une démonstration : nous passerons en revue les seuils, le regroupement et les règles d'escalade pour l'une de vos lignes.
Sources
- Energy Institute, Human factors briefing note no. 2: Alarm handling, 2011
- ANSI, ANSI/ISA 18.2-2016, Alarm Systems for the Process Industries, 2016
- ISA InTech, ISA18 charts updates to ISA/IEC alarm management standard and technical reports, 2017
- EEMUA, Publication 191: Alarm systems, a guide to design, management and procurement, 2024
- Vorne, The Six Big Losses, 2026
- Institute for Supply Management, The Monthly Metric: Unscheduled Downtime (synthèse des données Siemens), 2024
- Données pilote DBR77 IIoT, ligne de carton ondulé (client anonyme), 2026