Les 30 premiers jours de l'IoT dans une usine existante
DBR77 Team · Publié le
Pendant les 30 premiers jours de l'IoT dans une usine existante, visez une ligne où chaque arrêt est visible, où chaque arrêt a une cause et où une seule personne est responsable de la réaction. Si vous avez cela au bout de quatre semaines, le projet a une base solide pour les lignes suivantes, ce que des tableaux de bord pour vingt machines sur lesquels personne n'agit ne vous donneront pas.
Voici le plan que nous suivons, semaine par semaine, y compris pour connecter des machines de vingt ou trente ans.
Ce que le premier mois doit apporter, et ce qu'il ne doit pas apporter
Un bon premier mois apporte trois choses : l'état en direct de chaque machine d'une ligne, les causes d'arrêt saisies au moment de l'arrêt et un circuit d'alerte qui fonctionne, avec un responsable. Il apporte aussi une situation de référence, pour comparer les résultats futurs à quelque chose de réel.
Il ne doit pas apporter l'intégration à l'ERP, un déploiement sur toute l'usine ni des modèles prédictifs. Tout cela vient plus tard et dépend des données d'événements propres que crée le premier mois. McKinsey décrit comment beaucoup d'entreprises restent bloquées dans le « purgatoire des pilotes » ; vouloir tout faire d'un coup est l'un des chemins les plus rapides pour y tomber.
Les quatre semaines en un coup d'œil :
| Semaine | Objet | Ce qui est en place à la fin de la semaine |
|---|---|---|
| 1 | Périmètre, responsable et situation de référence | Une ligne choisie, un responsable de ligne issu de la production, le contrat de décision convenu, temps de réaction actuel et arrêts sans cause relevés |
| 2 | Connexion des machines | Chaque machine de la ligne remonte son état, les plus anciennes via un boîtier edge ou une caméra |
| 3 | Causes, alertes et responsables | Listes de causes courtes à chaque machine, circuits d'alerte vers un rôle par poste, règle d'escalade écrite |
| 4 | Premier bilan | Temps de réaction, arrêts sans cause et trois premières pertes comparés à la situation de référence, ligne suivante choisie |
Semaine 1 : périmètre, responsable et situation de référence
Choisissez une ligne, de préférence le goulot ou la ligne qui a le plus d'arrêts inexpliqués. Nommez un responsable de ligne issu de la production, pas de l'IT. Mettez-vous ensuite d'accord sur ce que nous appelons le contrat de décision :
- Les cinq indicateurs qui comptent sur cette ligne, par exemple disponibilité, temps de réaction, principales causes d'arrêt, production par poste et rebut.
- Qui agit sur chacun, par rôle et par poste.
- Quel seuil oblige cette personne à agir.
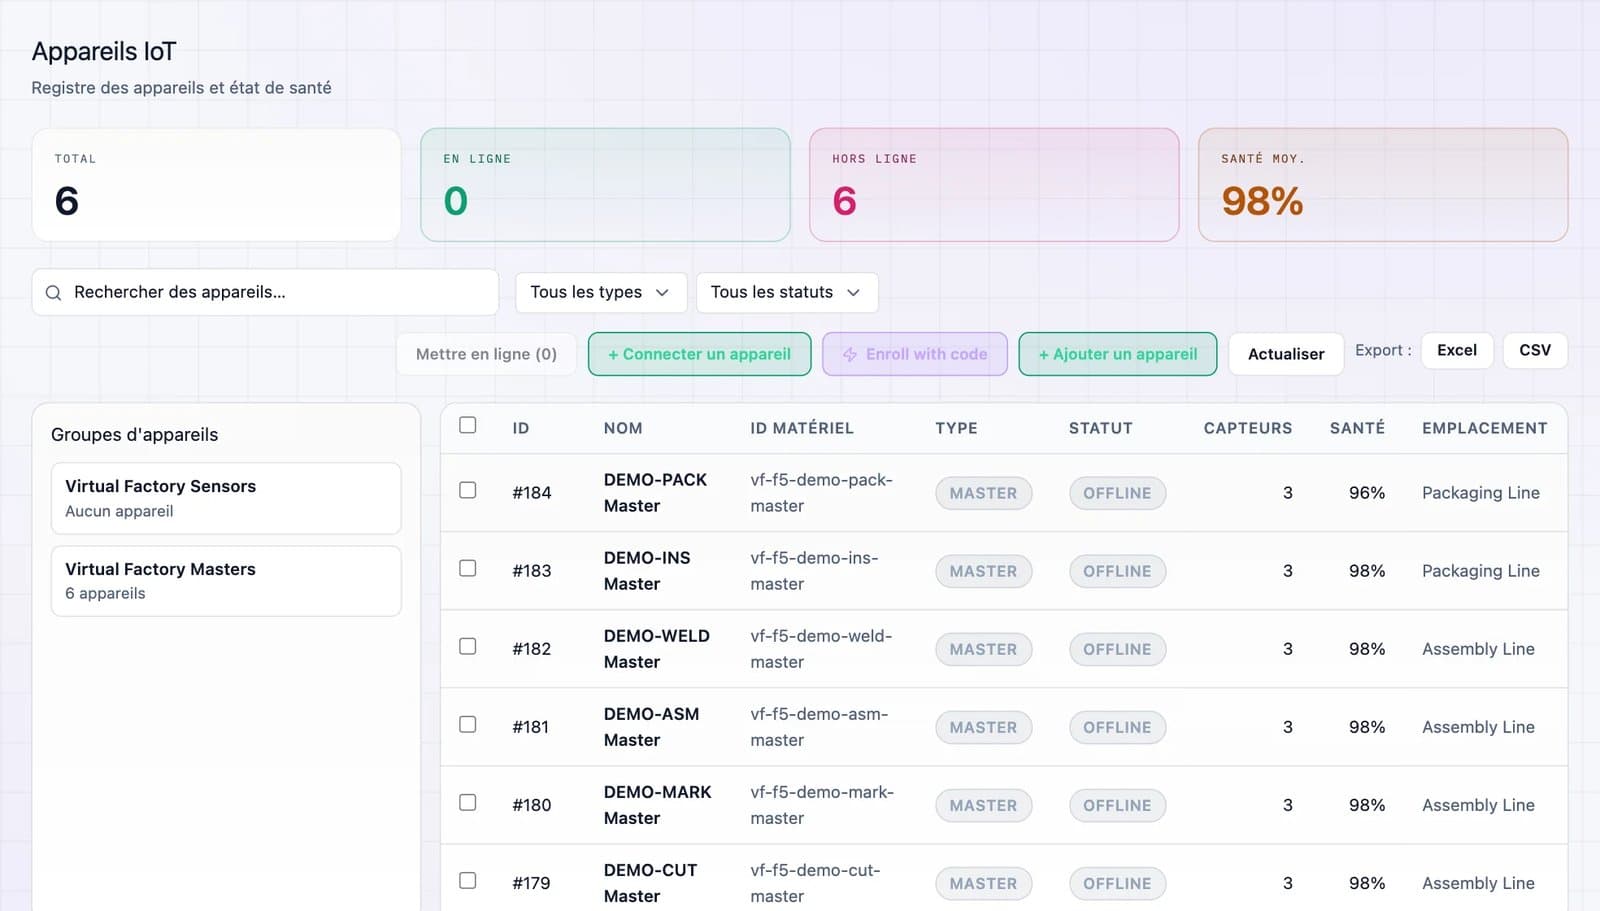
Terminez la semaine en relevant la situation actuelle : combien de temps prennent les réactions aujourd'hui et quelle part des arrêts n'a pas de cause.
Semaine 2 : connecter les machines, y compris les anciennes
Les lignes existantes mélangent des machines de différentes décennies. C'est normal, et la ligne n'a pas besoin d'être modernisée d'abord. Chaque type de machine reçoit la connexion qui lui convient.
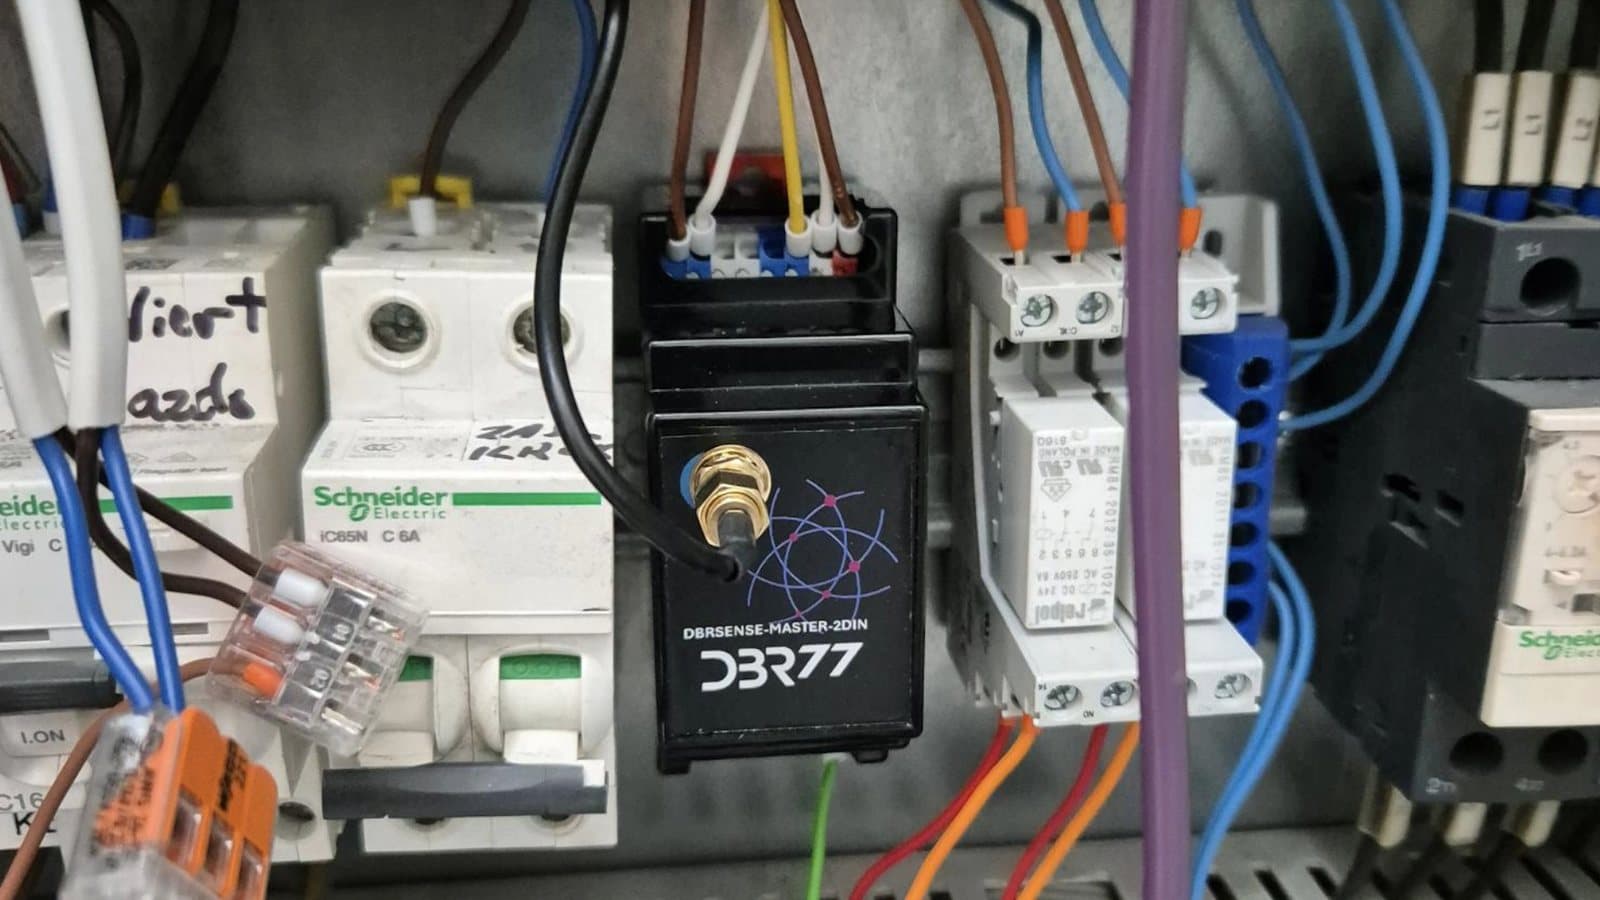
Un PLC est lu directement via OPC UA ou Modbus, les machines sans réseau ou sans PLC reçoivent un boîtier edge, et sur un poste sans aucun signal, une caméra avec IRIS Vision AI peut servir de capteur. Notre article sur la connexion des machines anciennes sans PLC détaille chacun de ces cas.
Les boîtiers edge transmettent les données via MQTT, un standard de messagerie léger. Le réseau s'adapte au bâtiment : Wi-Fi là où il passe, LoRaWAN pour les recoins des grands halls, une connexion SIM là où il n'y a aucun réseau.
Dans un cas de base modélisé pour un site existant typique, 11 machines sur 13 pouvaient être connectées et visibles en trois semaines environ. La ligne continue de tourner pendant l'installation ; l'essentiel des travaux se fait pendant les arrêts planifiés.
Vous ne savez pas comment connecter vos machines les plus anciennes ?
Envoyez-nous la liste des machines d'une ligne. Lors d'un appel de 30 minutes, nous passons chaque machine en revue avec la connexion qu'elle demande.
Semaine 3 : causes, alertes et responsables
Une fois que les machines remontent leur état, le travail passe au volet humain, où se crée l'essentiel de la valeur.
- Les listes de causes. Gardez-les courtes : 10 à 15 causes par type de machine, formulées avec les mots des opérateurs. Les listes longues finissent en « autre ».
- La saisie au moment de l'arrêt. L'opérateur choisit la cause sur une tablette à la machine. Cela prend environ deux secondes, tant que la cause est encore évidente.
- Les circuits d'alerte. Chaque type d'arrêt va vers un rôle du poste en cours : les pannes mécaniques à la maintenance, les ruptures de matière à la logistique.
- La règle d'escalade. Par exemple : sans prise en compte en 5 minutes, l'alerte part au chef d'équipe. Écrivez-la et informez le poste.
Attendez-vous à ce que les opérateurs testent le système les premiers jours. Si des causes manquent ou sont fausses, traitez-le comme un problème de liste et corrigez-la.
Semaine 4 : premier bilan et décision suivante
À la fin du mois, comparez la ligne avec la situation de référence de la semaine 1. Trois chiffres vous disent si le projet fonctionne :
- le temps de réaction entre l'arrêt et la première action ;
- la part du temps d'arrêt sans cause ;
- les trois premières pertes en minutes, désormais calculées à partir des arrêts enregistrés.
Le temps de réaction est en général le premier de ces chiffres à bouger : sur une ligne de carton ondulé, il est passé de 24 à 9 minutes une fois les arrêts visibles et attribués.
Clôturez le mois par une décision : quoi améliorer sur cette ligne et quelle ligne vient ensuite. L'article sur les 90 premiers jours explique quoi mesurer ensuite. Une fois une ligne connectée, les mêmes données peuvent aussi alimenter un jumeau numérique de la ligne pour tester des changements avant de les faire sur le terrain.
Les erreurs qui ralentissent le premier mois
- Démarrer avec trop de lignes. Faites bien fonctionner une ligne avant d'ajouter la suivante.
- Un projet piloté par l'IT sans responsable production. C'est le responsable de ligne qui décide de ce qui compte.
- Reprendre les codes de cause de l'ERP. Ces codes sont conçus pour la comptabilité ; les opérateurs ont besoin de causes formulées avec les mots qu'ils utilisent à la machine.
- Des alertes sans responsable. Adressez chaque type d'arrêt à un rôle du poste, comme en semaine 3.
- Pas de situation de référence. Sans les chiffres de la semaine 1, personne ne peut prouver le résultat.
Questions fréquentes
La production doit-elle s'arrêter pendant l'installation ?
Non. Les connexions en lecture seule aux PLC et les capteurs à pince s'installent en fonctionnement normal ou pendant les arrêts planifiés. La logique de commande des machines reste telle quelle.
Et si nos machines n'ont pas de PLC ?
Un boîtier edge lit alors les signaux disponibles, comme le courant moteur, la colonne lumineuse ou un capteur de cycle. Pour les postes manuels sans aucun signal, une caméra peut servir de capteur.
De quel réseau avons-nous besoin ?
De celui qui atteint les machines. Le Wi-Fi est le plus courant. LoRaWAN couvre les grands halls avec peu de points d'accès, et une connexion SIM fonctionne là où il n'y a pas de réseau usine.
Qui doit être impliqué de notre côté ?
Un responsable de ligne issu de la production, une personne de la maintenance et un interlocuteur IT/OT pour les questions de réseau et de sécurité. Quelques heures par semaine pour chacun suffisent le premier mois.
Que se passe-t-il après 30 jours ?
La ligne fonctionne avec l'état en direct, les causes et les circuits d'alerte. Viennent ensuite les actions d'amélioration sur les principales pertes et la décision sur les lignes suivantes. Les revues de sécurité s'appuient en général sur l'ISA/IEC 62443 ; le traitement reste sur site, à l'intérieur de votre périmètre IT/OT.
Conclusion
Si vous planifiez maintenant le premier mois, commencez par le travail de la semaine 1 : choisissez la ligne, nommez le responsable issu de la production et mettez par écrit le contrat de décision. La même semaine, dressez la liste de toutes les machines de cette ligne avec leur âge et en indiquant si elles ont un PLC et une connexion réseau, afin que l'installation de la semaine 2 puisse être planifiée autour des arrêts planifiés de la ligne.
Planifiez les 30 premiers jours sur votre ligne
Nous fixons avec vous le périmètre, le responsable, la situation de référence et les critères de réussite, puis nous connectons la ligne sans arrêter la production.
Sources
- OPC Foundation, OPC Unified Architecture
- Modbus Organization, modbus.org
- OASIS, MQTT Version 5.0
- LoRa Alliance, About LoRaWAN
- ISA, ISA/IEC 62443 series of standards
- McKinsey & Company, IoT value set to accelerate through 2030
- Données des pilotes DBR77 IIoT et cas de base modélisés, 2026