Jak zespół może nauczyć kamerę, czego ma szukać, bez zbierania danych?
DBR77 Team · Opublikowano
Zespół może nauczyć kamerę, opisując słowami, czego ma szukać i jak wygląda dobry, a jak zły wynik. W DBR77 IIoT inżynier wpisuje obiekt (na przykład „śruby na kołnierzu A”), wynik pożądany („10 z 10 założonych i zabezpieczonych drutem”) i niepożądany („brak śruby albo zła śruba”). Kilka części oznaczonych jako OK albo NOK to dla systemu wzorzec z Twojej linii. Każda scena ma potem trzy wyniki: pożądany, niepożądany i odchylenie, którego nikt jeszcze nie opisał, a które inżynier nazywa raz. Nie trzeba zbierać danych ani prowadzić projektu uczenia modelu, ale każdą kontrolę trzeba przed uruchomieniem sprawdzić na zdjęciach z własnej linii.
To kolejny artykuł z serii o kamerach w produkcji. W innych częściach piszemy o tym, jak kamera porównuje każdą śrubę ze wzorcem, i jak sprawdza, czy kroki montażu wykonano we właściwej kolejności.
Dlaczego klasyczna wizja maszynowa potrzebuje setek zdjęć
Większość systemów wizyjnych uczy się stałej listy kategorii. Autorzy modelu CLIP, który łączy obraz z tekstem, piszą, że to ogranicza zastosowanie takich systemów, bo każda nowa rzecz do rozpoznania wymaga nowych opisanych danych. Każda nowa część, narzędzie czy wada to kolejne zdjęcia i etykiety.
Przy kontroli jakości takie zdjęcia trudno zdobyć. Autorzy MVTec AD, popularnego zbioru testowego do kontroli przemysłowej, zwracają uwagę, że procesy przemysłowe ustawia się tak, żeby wad było jak najmniej. Dobra linia robi mało braków, więc na zdjęcia każdej wady trzeba długo czekać.
W praktyce często kończy się to projektem wizyjnym tylko dla tej kontroli, która najbardziej się opłaca, a reszta zostaje na papierze.
Jak działa opisywanie słowami
Nowsze modele wykrywają obiekty na podstawie opisu, a nie stałej listy. Taki jest na przykład badawczy model Grounding DINO: wykrywa dowolne obiekty na podstawie tego, co poda człowiek, na przykład nazwy kategorii albo opisu. Mówi się na to wykrywanie z otwartym słownikiem.
Vision AI w DBR77 IIoT działa według tej zasady w dwóch krokach:
- Uczenie. Inżynier opisuje scenę: czego szukać, jak wygląda wynik pożądany, a jak niepożądany. Przy drobnych różnicach zespół oznacza kilka części jako OK albo NOK i od tej chwili system sprawdza jakość według tego wzorca.
- Patrzenie. Każdy obraz system porównuje z tym, czego go nauczono, i daje jeden z trzech wyników opisanych niżej.
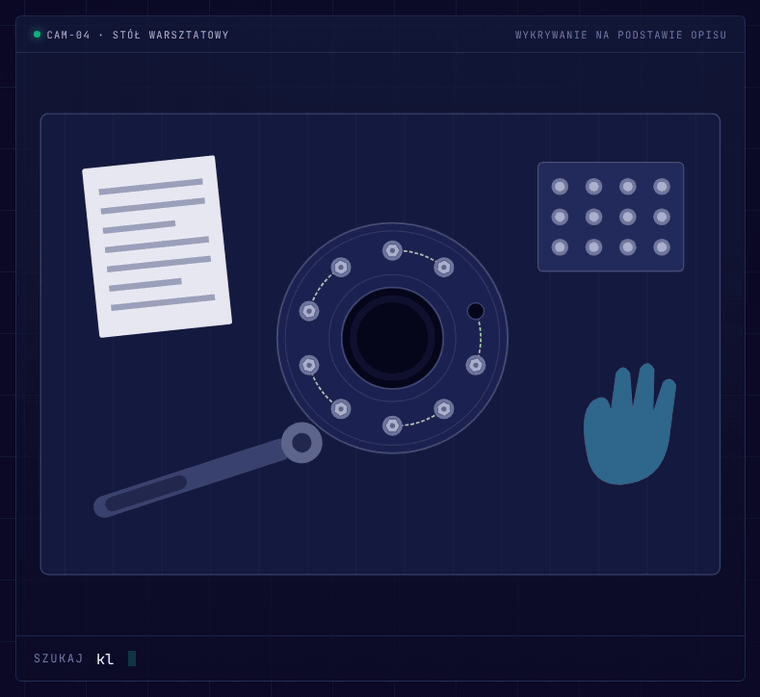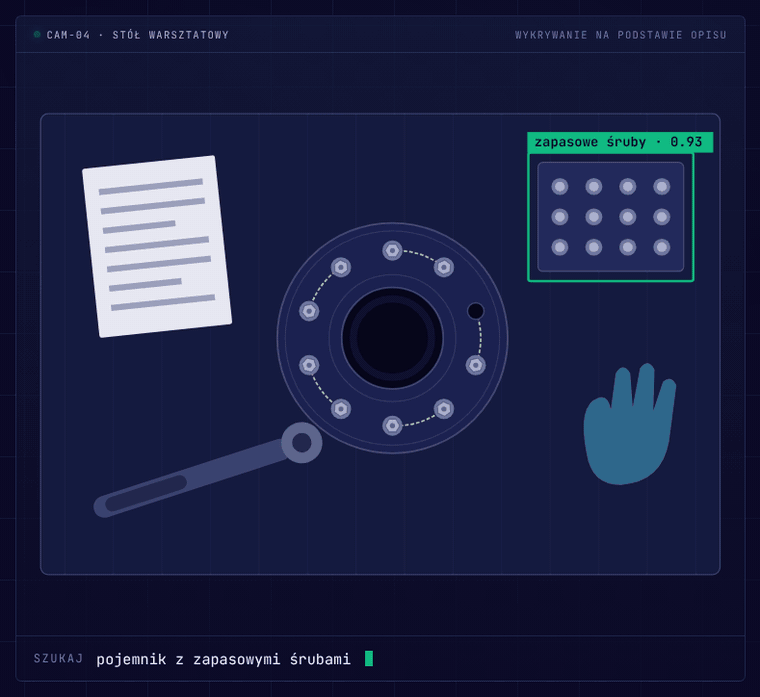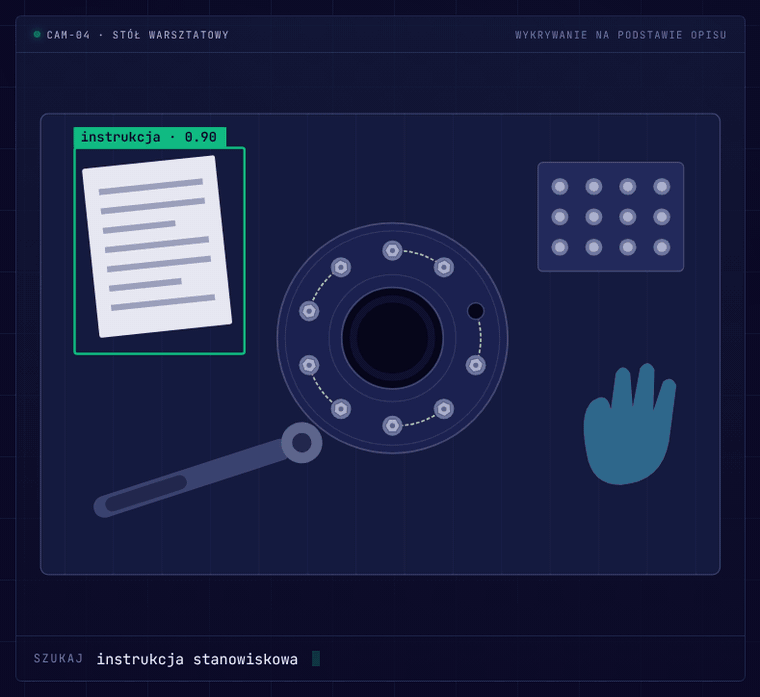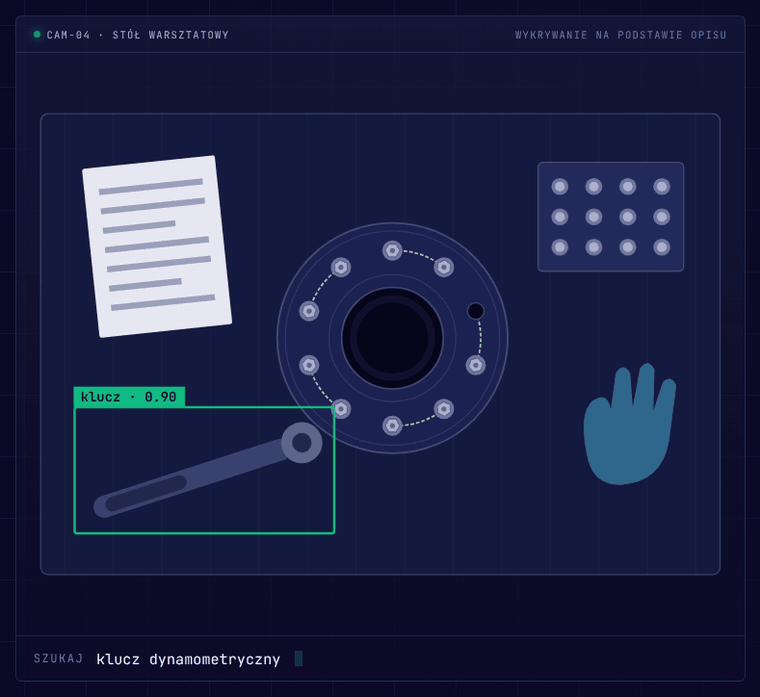
Przykład poglądowy na podstawie prezentacji DBR77 Vision AI: każdy obiekt dostaje ramkę, gdy tylko zostanie opisany słowami.
W tym przykładzie poglądowym kamera patrzy na stół warsztatowy. Inżynier wpisuje „klucz dynamometryczny”, „pojemnik z zapasowymi śrubami”, „kołnierz, puste miejsce na śrubę”, „instrukcja stanowiskowa” i „dłoń technika w rękawicy”. Każdy obiekt dostaje ramkę, gdy tylko zostanie opisany, a puste miejsce jest zaznaczone na czerwono.
Inżynierowie i technicy mogą dodawać nowe kontrole w trakcie pracy. Gdy na linii pojawia się nowa część albo nowe narzędzie, opisują je i od tej chwili kamera ich szuka.
Trzy wyniki każdej sceny
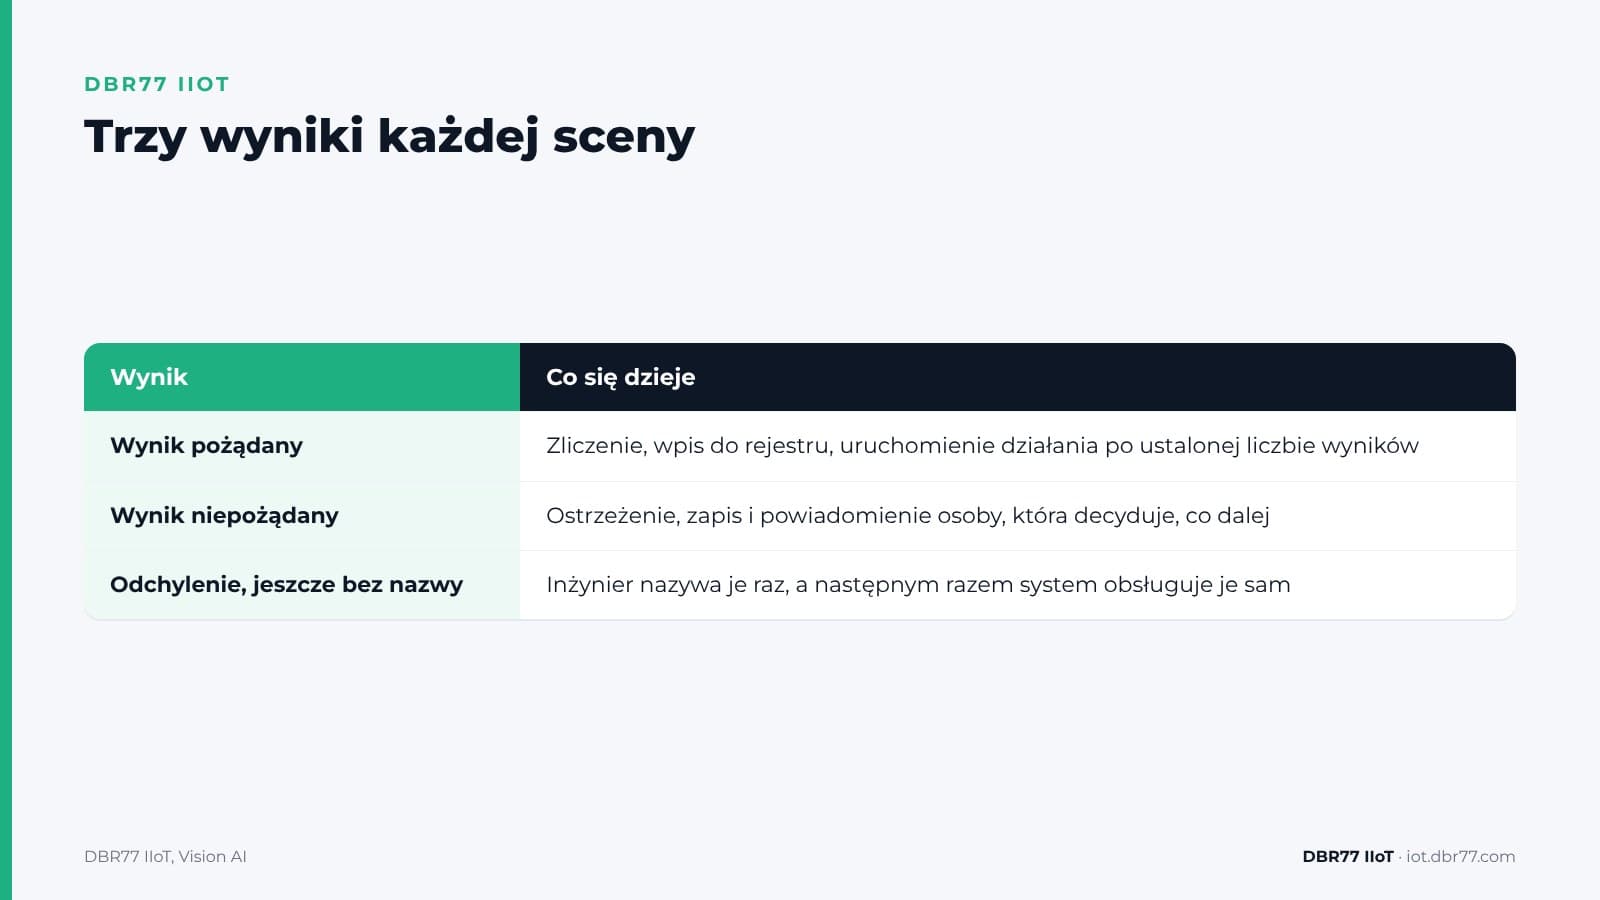
Każda kontrola ma trzy możliwe wyniki, a zespół ustala, co dzieje się przy każdym z nich:
- Wynik pożądany. System go zlicza i zapisuje w rejestrze, a po ustalonej liczbie wyników może uruchomić kolejny krok. Przykład: śruba 7 jest założona i potwierdzona, a po 10 z 10 system robi to, co ustalił zespół, na przykład wysyła komunikat, że kołnierz A jest gotowy.
- Wynik niepożądany. System ostrzega, zapisuje zdarzenie i powiadamia wybraną osobę. Na przykład na pozycji 4 jest śruba złego typu, a technik dostaje zdjęcie z zaznaczonym miejscem. System nie zatrzymuje maszyn. O tym, co dalej, decyduje człowiek.
- Odchylenie, jeszcze bez nazwy. Pojawia się coś, czego nikt nie opisał, na przykład nieznany przedmiot na kołnierzu. Inżynier raz je nazywa i powstaje nowa kategoria z własnymi działaniami. Później system sam ją rozpozna i obsłuży, a kategoria dołącza do tego, czego nauczono go w kroku 1.
| Wynik | Co się dzieje |
|---|---|
| Wynik pożądany | Zliczenie, wpis do rejestru, uruchomienie działania po ustalonej liczbie wyników |
| Wynik niepożądany | Ostrzeżenie, zapis i powiadomienie osoby, która decyduje, co dalej |
| Odchylenie, jeszcze bez nazwy | Inżynier nazywa je raz, a następnym razem system obsługuje je sam |
Dzięki trzeciemu wynikowi system nie stoi w miejscu. Badacze opisują podobną ideę, wykrywanie w otwartym świecie: detektor oznacza obiekty, których go nie uczono, jako nieznane, a spośród nieznanych te ważne nazywa człowiek. Na hali tym człowiekiem jest Twój inżynier.
Opisz jedną kontrolę ze swojej linii
Prześlij nam kilka zdjęć i jeden lub dwa krótkie filmy ze stanowiska, zrobione zgodnie z zasadami obowiązującymi w zakładzie, i napisz słowami, czego kamera ma szukać. Pokażemy, co system znajdzie, a czego nie.
Gdzie opis słowami nie wystarcza
Opis tekstowy działa najlepiej, gdy obiekt wygląda dokładnie tak, jak go opisano. Badania wskazują dwa słabe punkty.
Pierwszy to nowe środowiska. Test na 100 zbiorach danych z różnych dziedzin pokazał, że modele, których nie uczono na danym zbiorze, w nowych środowiskach wyraźnie tracą skuteczność. Hala produkcyjna, z własnymi częściami, oświetleniem i kątami kamery, może być takim środowiskiem.
Drugi to drobne szczegóły. Badanie z 2023 roku pokazało, że detektory z otwartym słownikiem słabo wychwytują i rozróżniają drobne szczegóły, takich jak kolor, wzór czy materiał. Jeszcze dalej idzie preprint z 2025 roku. Autorzy testowali nowe modele bazowe z opisami tekstowymi na zdjęciach z produkcji seryjnej i piszą, że wszystkie zawiodły na danych z prawdziwej produkcji, choć na publicznych zbiorach testowych wypadały dobrze.
Dlatego opis słowami to dopiero pierwszy krok. Test na Twoich zdjęciach pokazuje, gdzie opis wystarcza. Do drobnych różnic, takich jak założony albo brakujący drut zabezpieczający, służy wzorzec OK/NOK, a test sprawdzi, czy i on daje radę. Trzeci wynik zgłasza odchylenia, które kamera zauważy, choć nikt ich nie opisał.
Kto odpowiada za reguły i reakcje
Kontrola ma sens tylko wtedy, gdy ktoś reaguje na jej wynik. W lean od dawna to sprawa ludzi na hali: tablica andon sygnalizuje każdą nieprawidłowość, a lider zespołu reaguje. W Vision AI kontrole i reakcje ustalają ci sami ludzie, którzy znają stanowisko.
Zanim pierwsza kontrola ruszy, ustal kilka rzeczy:
- Kto może dodawać kontrole. Na przykład inżynier procesu i główny technik na zmianie.
- Jak nazywać nowe kategorie. Krótko i zrozumiale dla każdego na linii. Listę nazw trzymaj w jednym miejscu.
- Kto przegląda trzeci wynik. Ktoś sprawdza odchylenia bez nazwy co zmianę albo co tydzień, żeby się nie piętrzyły.
- Kto dostaje które powiadomienie. Nadmiar alarmów uczy ludzi je ignorować, o czym piszemy w artykule o tym, dlaczego alarmy IIoT zawodzą na hali.
Jak to przetestować na jednym stanowisku
Test przebiega tak samo jak przy innych kontrolach Vision AI: demo i omówienie stanowiska, test na kilku zdjęciach i krótkich filmach po podpisaniu NDA, proof of concept na jednym stanowisku i wdrożenie tylko wtedy, gdy wyniki Cię przekonają.
- Kamera. Wystarczy zwykła kamera IP. Każdy obraz jest analizowany w około 25 ms na komputerze w Twoim zakładzie.
- Opis. Inżynier opisuje słowami, czego szukać i co jest dobrym, a co złym wynikiem, a zespół może dodawać nowe kontrole w trakcie pracy. Nie trzeba zbierać danych ani prowadzić projektu uczenia modelu.
- Reakcja. Bez programowania ustawiasz, co ma się stać: zliczenie, zapis, ostrzeżenie albo powiadomienie wybranej osoby. System nie zatrzymuje maszyn. Decyzja należy do człowieka.
- Koszt. Składają się na niego jednostka brzegowa, układ AI, kamery i miesięczna licencja na oprogramowanie dla każdej jednostki. Jedna jednostka może jednocześnie analizować obraz nawet z 40 kamer.
Kiedy kamera sprawdza się lepiej niż czujnik, a kiedy gorzej, piszemy w artykule o kamerach jako czujnikach.
Gdzie to jest w DBR77 IIoT
Vision AI to część DBR77 IIoT odpowiedzialna za kamery. Obowiązują tu te same zasady co w całym systemie:
- Nasze urządzenia tylko odczytują dane. Nigdy nie wysyłają poleceń do Twoich maszyn i nie ingerują w układ sterowania.
- Obraz jest analizowany na miejscu, a wideo nie jest nagrywane.
- Vision AI działa na DBR77 Vector, naszej własnej przemysłowej sztucznej inteligencji, którą można zainstalować na Twoich serwerach. Bez pisemnej zgody Twoje dane nie służą do uczenia żadnego modelu. DBR77 ma certyfikat ISO/IEC 27001:2022.
- Zdarzenia z Vision AI trafiają do IRIS razem z danymi z maszyn.
Najczęstsze pytania
Czy najpierw trzeba zebrać zdjęcia?
Nie do uczenia systemu. Do testu prosimy o kilka zdjęć i jeden lub dwa krótkie filmy ze stanowiska, a przy drobnych różnicach zespół oznacza kilka części jako OK albo NOK, żeby był wzorzec.
Kto może dodać nową kontrolę?
Inżynierowie i technicy, w trakcie pracy. Opisują słowami obiekt oraz dobry i zły wynik, a reakcję ustawiają bez programowania.
Co się dzieje, gdy kamera zobaczy coś, czego nikt nie opisał?
Zgłasza to jako odchylenie bez nazwy. Inżynier nazywa je raz i ustala, co ma się dziać, a następnym razem system obsługuje je sam.
Czy to działa dla każdej części?
Nie samo z siebie. Opis tekstowy słabiej radzi sobie z drobnymi szczegółami i nietypowymi częściami, dlatego każdą kontrolę najpierw testujemy na zdjęciach z Twojej linii, a wzorzec OK/NOK służy do różnic, których słowa nie oddają.
Czy kontrola może zatrzymać linię?
Nie. Kontrola może zliczyć, zapisać, ostrzec albo powiadomić wybraną osobę. System nie zatrzymuje maszyn. Decyduje człowiek.
Podsumowanie
Wybierz jedno stanowisko, na którym kontrolę wciąż robi się na oko albo na papierze, i zapisz prostymi słowami, czego kamera ma szukać, jak wygląda dobry wynik, a jak zły. Odłóż kilka części OK i NOK i ustal, kto dostaje powiadomienie, gdy coś pójdzie nie tak. Potem zdecyduj, kto będzie nazywał odchylenia, których nikt nie opisał. Wtedy możesz zacząć pierwszy test na zdjęciach i krótkich filmach ze stanowiska.
Przyjdź na demo z jedną kontrolą
Przynieś opis jednej kontroli ze swojej linii. Zobaczysz, jak się ją wpisuje i jakie wyniki daje na podobnym przykładzie, a my powiemy, czego potrzeba w Twoim zakładzie.
Źródła
- A. Radford i in., Learning Transferable Visual Models From Natural Language Supervision, 2021
- P. Bergmann i in., MVTec AD: A Comprehensive Real-World Dataset for Unsupervised Anomaly Detection, CVPR, 2019
- S. Liu i in., Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection, 2023
- F. Ciaglia i in., Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark, 2022
- L. Bianchi i in., The devil is in the fine-grained details: Evaluating open-vocabulary object detectors for fine-grained understanding, 2023
- S. Baeuerle i in., Are Foundation Models Ready for Industrial Defect Recognition? A Reality Check on Real-World Data, preprint, 2025
- K.J. Joseph i in., Towards Open World Object Detection, CVPR, 2021
- Lean Enterprise Institute, Lean Lexicon, 5th edition, excerpt
- DBR77, DBR77 IIoT, 2026
- DBR77, prezentacja IIoT i Vision AI dla klientów, 2026