¿Cómo puede su equipo enseñar a una cámara qué buscar sin un conjunto de datos?
DBR77 Team · Publicado el
Su equipo puede enseñar a una cámara describiendo con palabras qué debe buscar y cómo es un resultado bueno y uno malo. En DBR77 IIoT, un ingeniero escribe el objeto, por ejemplo «tornillos de la brida A», el resultado conforme, «10 de 10 colocados y asegurados con alambre», y el no conforme, «falta un tornillo o no es el correcto». Unas cuantas piezas marcadas como OK o NOK le dan al sistema un patrón de su propia línea. A partir de ahí, cada escena tiene tres resultados: el conforme, el no conforme y una desviación que nadie ha descrito todavía, a la que un ingeniero pone nombre una sola vez. No hay que reunir un conjunto de datos ni montar un proyecto de entrenamiento, pero cada control debe probarse con fotos de su línea antes de ponerlo en marcha.
Este artículo forma parte de nuestra serie sobre cámaras en producción. Las otras partes explican cómo comparar cada tornillo con un patrón y cómo comprobar que cada paso se hizo en el orden correcto.
Por qué la visión artificial clásica necesita un conjunto de datos
La mayoría de los sistemas de visión aprenden una lista fija de categorías. Los autores de CLIP, un modelo que relaciona imágenes y texto, explican el inconveniente de ese enfoque: limita su alcance, porque cada concepto visual nuevo exige más datos etiquetados. Cada pieza, herramienta o defecto nuevo obliga a reunir y etiquetar otro lote de imágenes.
En los controles de calidad, esas imágenes son difíciles de conseguir. El artículo de MVTec AD, un benchmark muy usado en inspección industrial, señala que los procesos industriales se optimizan para producir el mínimo de piezas defectuosas. Una buena línea fabrica pocas piezas malas, así que reunir suficientes ejemplos de cada defecto lleva tiempo.
En la práctica, muchas veces solo se monta un proyecto de visión para el control más rentable, y los demás se quedan en papel.
Cómo funciona la descripción con palabras
Los modelos de detección más recientes trabajan con una descripción de texto en lugar de una lista fija. Grounding DINO, un modelo de investigación de este tipo, detecta cualquier objeto a partir de lo que indique una persona, como el nombre de una categoría o una expresión que lo describa. A esto se le llama detección de vocabulario abierto.
En DBR77 IIoT, Vision AI aplica este principio en dos pasos:
- Enseñar. Un ingeniero describe la escena: qué hay que buscar, cómo es el resultado conforme y cómo es el no conforme. Cuando las diferencias son sutiles, el equipo marca algunas piezas como OK o NOK y, desde ese momento, la calidad se comprueba con ese patrón.
- Ver. Cada imagen se compara con lo que se le ha enseñado al sistema y acaba en uno de los tres resultados que explicamos más abajo.
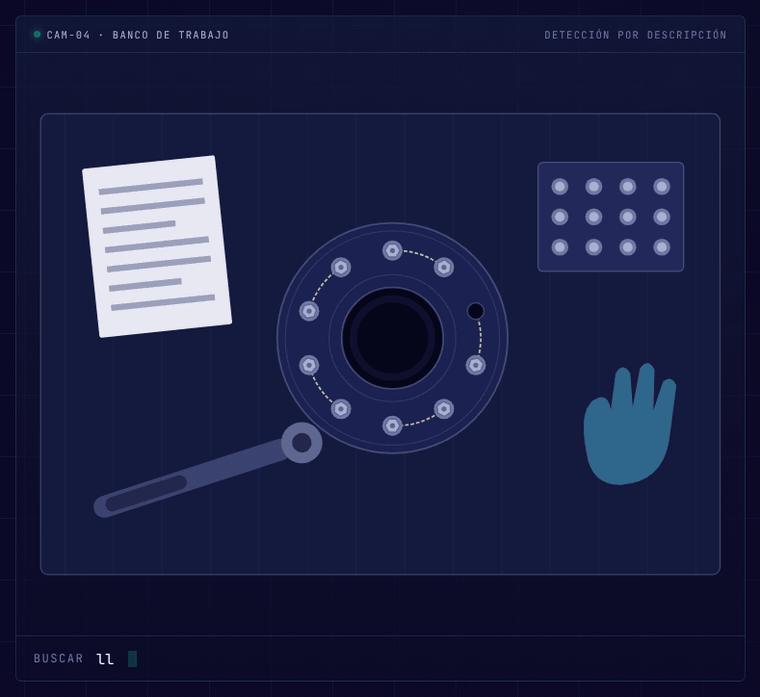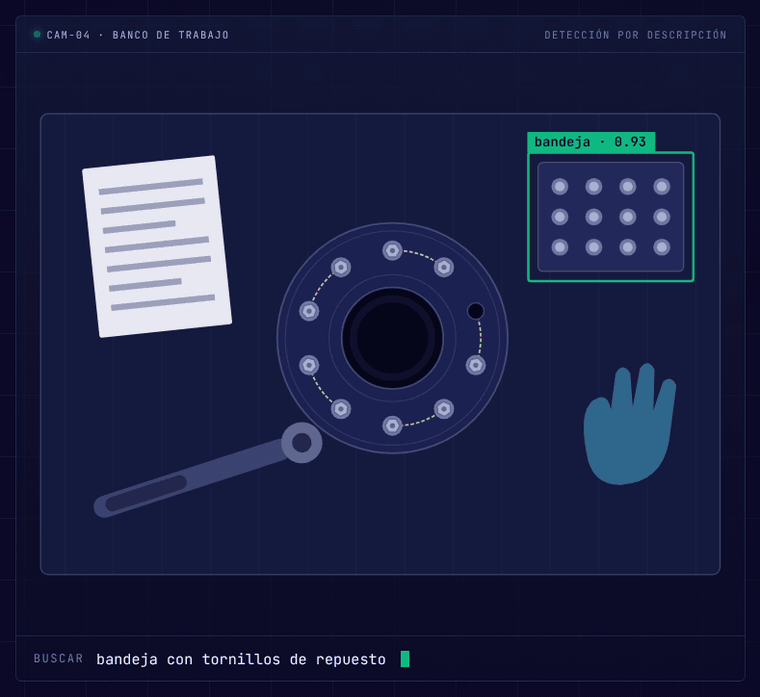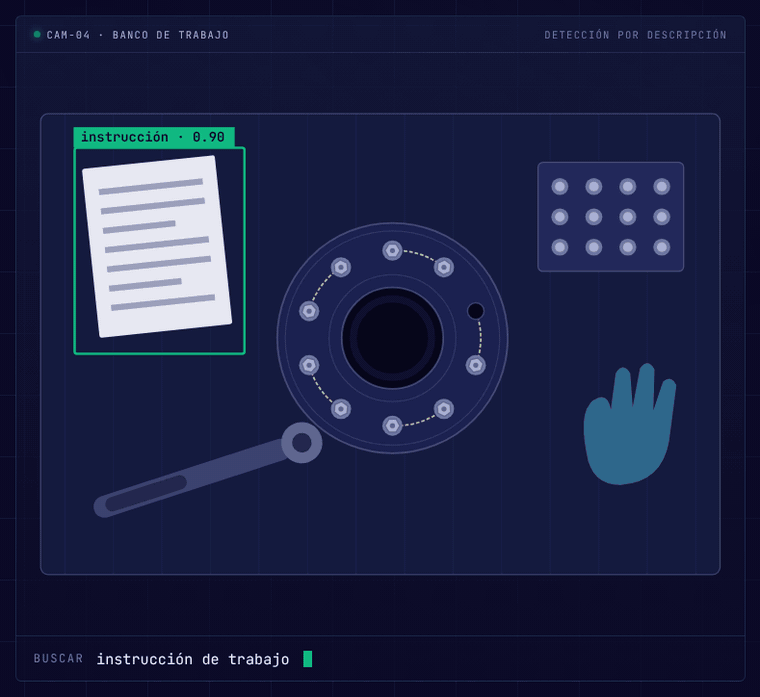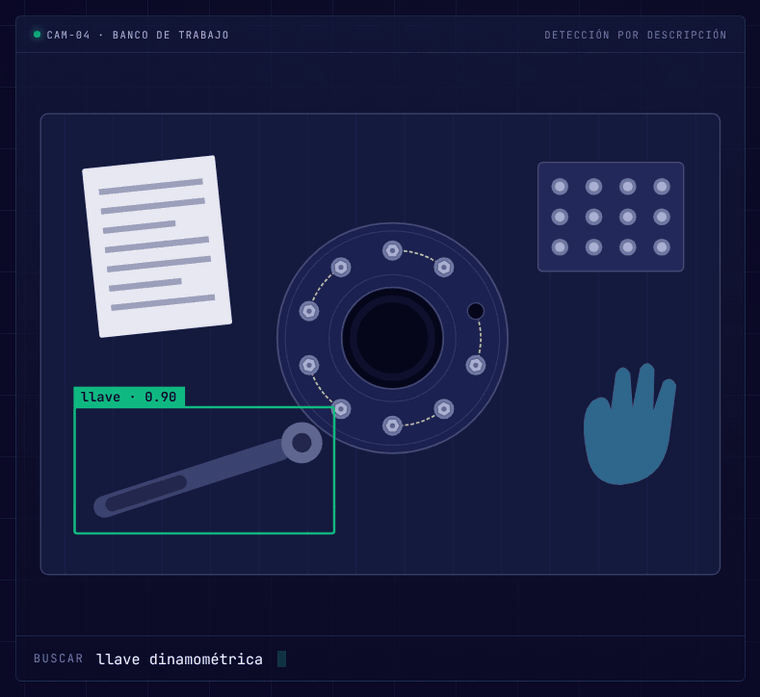
Ejemplo ilustrativo basado en la presentación de DBR77 Vision AI: cada objeto aparece enmarcado en cuanto se describe con palabras.
En este ejemplo ilustrativo, una cámara enfoca un banco de trabajo. El ingeniero escribe «llave dinamométrica», «bandeja con tornillos de repuesto», «brida, posición sin tornillo», «instrucción de trabajo» y «mano del técnico con guante». Cada objeto aparece enmarcado en cuanto se describe, y la posición vacía se marca en rojo.
Los ingenieros y los técnicos pueden añadir controles nuevos con el sistema en marcha. Cuando llega a la línea una pieza o una herramienta nueva, la describen y la cámara empieza a buscarla.
Tres resultados para cada escena
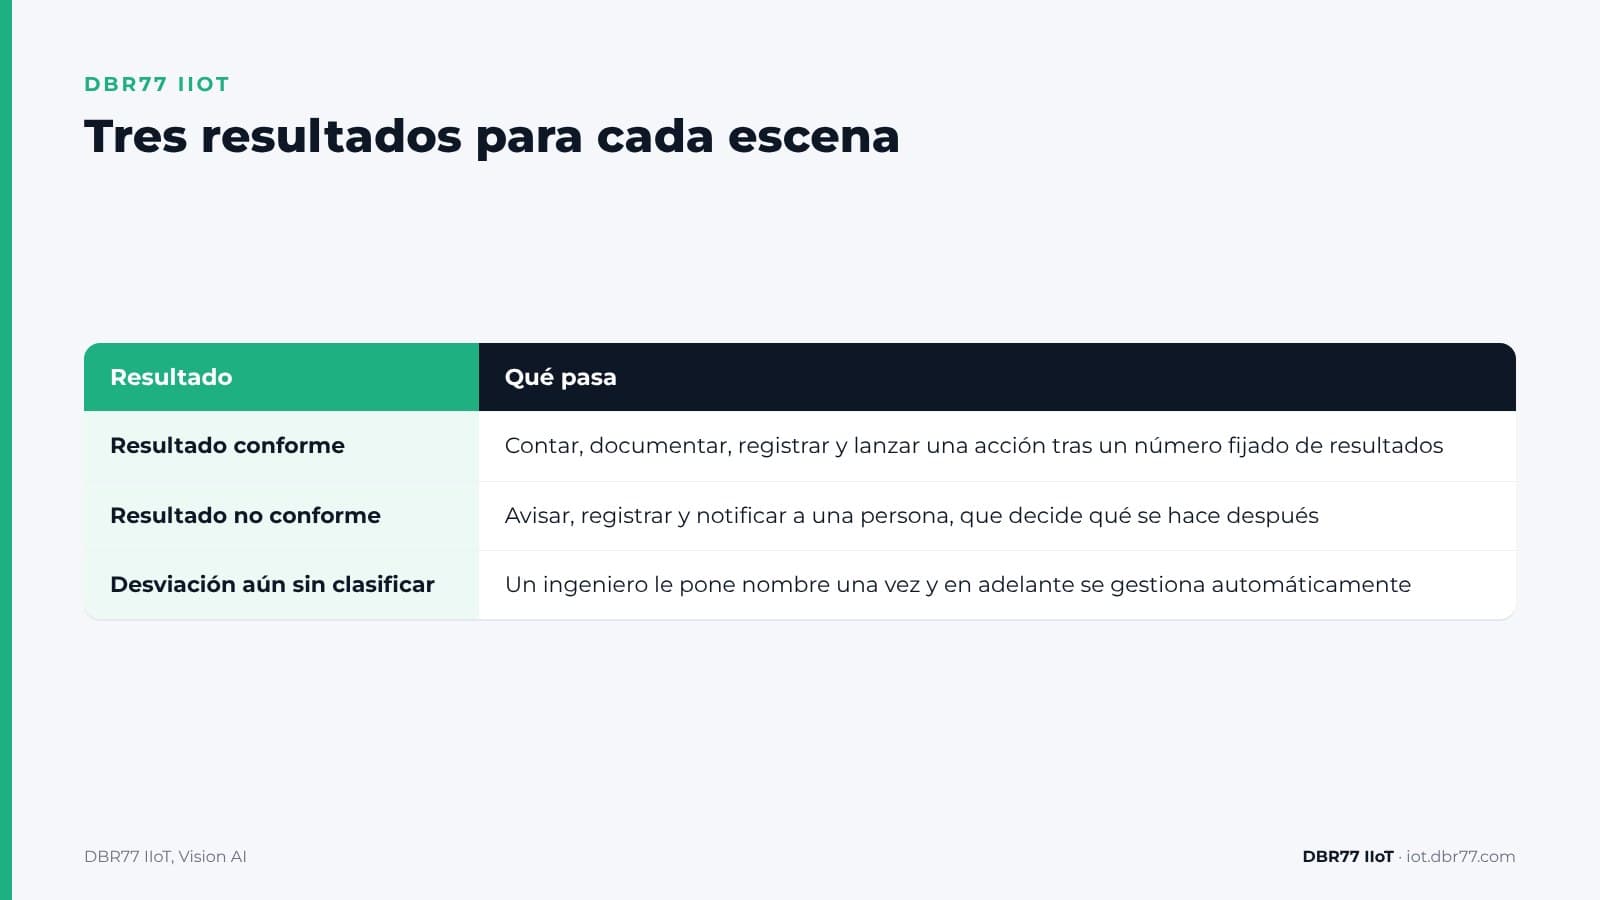
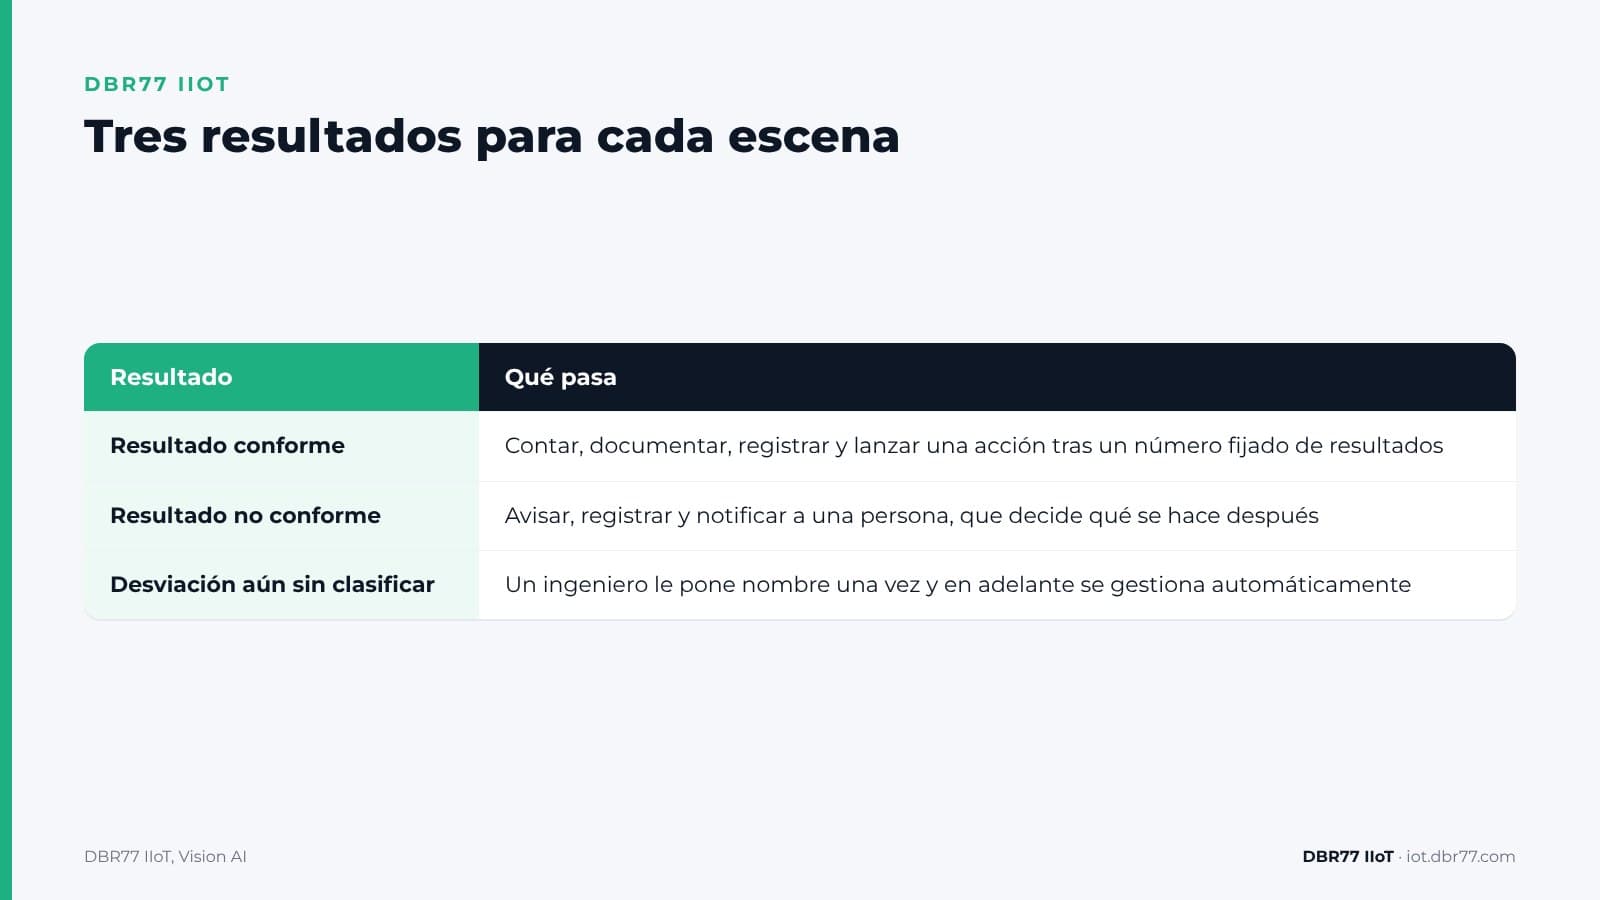
Cada control tiene tres resultados posibles, y el equipo decide qué pasa con cada uno:
- Resultado conforme. El sistema lo cuenta, lo documenta y lo registra, y puede activar el paso siguiente tras un número fijado de resultados. Por ejemplo, el tornillo 7 está colocado y confirmado, y con 10 de 10 el sistema lanza la acción que haya definido el equipo, como un mensaje de que la brida A está terminada.
- Resultado no conforme. El sistema avisa, lo registra y notifica a una persona. Por ejemplo, el tornillo de la posición 4 no es del tipo correcto, y el técnico recibe una imagen con la zona marcada. El sistema no para ninguna máquina: lo que se hace después lo decide una persona.
- Desviación aún sin clasificar. Aparece algo que nadie ha descrito, por ejemplo un objeto desconocido sobre la brida. Un ingeniero le pone nombre una sola vez. Así nace una categoría nueva con sus propias acciones y, la próxima vez, el sistema la reconoce y la gestiona automáticamente. Esa categoría se suma a lo que se enseñó en el paso 1.
| Resultado | Qué pasa |
|---|---|
| Resultado conforme | Contar, documentar, registrar y lanzar una acción tras un número fijado de resultados |
| Resultado no conforme | Avisar, registrar y notificar a una persona, que decide qué se hace después |
| Desviación aún sin clasificar | Un ingeniero le pone nombre una vez y en adelante se gestiona automáticamente |
El tercer resultado es el que mantiene el sistema al día. Los investigadores describen una idea parecida, la detección en mundo abierto: un detector marca como desconocidos los objetos que no se le han enseñado, y un oráculo etiqueta los objetos que interesan entre todos los desconocidos. En planta, ese oráculo es su ingeniero.
Describa un control de su línea
Envíenos unas cuantas fotos y uno o dos vídeos cortos de un puesto, tomados según sus normas internas sobre fotografías, y díganos con palabras qué hay que buscar. Le mostramos lo que el sistema detecta y lo que se le escapa.
Dónde no basta con describir
Una descripción de texto funciona mejor cuando el objeto se parece a lo que dicen las palabras. Los estudios señalan dos puntos débiles.
El primero son los entornos nuevos. Un benchmark de 100 conjuntos de datos de ámbitos muy distintos mostró que los modelos de detección zero-shot, que no se han entrenado con esos datos, pierden bastante rendimiento al pasar a entornos nuevos. Una planta, con sus propias piezas, su iluminación y sus ángulos, puede ser uno de esos entornos.
El segundo son los detalles finos. Un estudio de 2023 sobre detectores de vocabulario abierto concluyó que les cuesta captar y distinguir con precisión los detalles más finos de los objetos, como el color, el dibujo o el material. Un preprint de 2025 fue más allá: probó modelos fundacionales recientes con descripciones de texto sobre imágenes industriales reales de producción en serie. Sus autores escriben que todos los modelos fallan con sus datos reales, mientras que esos mismos modelos funcionan bien en benchmarks públicos.
Por eso describir es solo el primer paso. La prueba con sus fotos muestra dónde basta la descripción. Para diferencias sutiles, como un alambre de seguridad puesto o ausente, está el patrón OK/NOK, y la misma prueba indica si es suficiente. El tercer resultado señala las desviaciones que la cámara ve y que nadie ha descrito.
Quién se encarga de las reglas y las reacciones
Un control solo sirve si alguien hace algo con su resultado. En lean, de eso se encarga desde hace mucho la propia planta: un tablero andon emite una señal cada vez que se produce una anomalía, y el jefe de equipo acude. Con Vision AI, las mismas personas que conocen el puesto escriben los controles y deciden las reacciones.
Antes de poner en marcha el primer control, deje acordado lo siguiente:
- Quién puede añadir controles. Por ejemplo, el ingeniero de procesos y el técnico responsable del turno.
- Cómo se nombran las categorías nuevas. Con nombres cortos que entienda todo el mundo en la línea, anotados en un solo sitio.
- Quién revisa el tercer resultado. Alguien mira las desviaciones aún sin clasificar en cada turno o cada semana, para que no se acumulen.
- Quién recibe cada notificación. Demasiadas alarmas acostumbran a la gente a ignorarlas, como explicamos en nuestro artículo sobre por qué fallan las alertas de IIoT en planta.
Cómo probarlo en un puesto
La prueba sigue el mismo camino que cualquier control de Vision AI: una demo y una revisión de su puesto, un ensayo con unas cuantas fotos y vídeos cortos bajo un acuerdo de confidencialidad (NDA), una prueba de concepto en un puesto y, solo si los resultados le convencen, el despliegue.
- Cámara. Sirve cualquier cámara IP estándar. Cada imagen se analiza en unos 25 ms en un equipo situado en sus instalaciones.
- Definiciones. Un ingeniero describe con palabras qué hay que buscar y qué cuenta como resultado bueno y qué como malo, y el equipo puede añadir controles nuevos con el sistema en marcha. No hay que reunir un conjunto de datos ni montar un proyecto de entrenamiento.
- Reacción. Usted decide qué pasa: contar, registrar, avisar o notificar a una persona, sin programar. El sistema no para ninguna máquina: la decisión es de una persona.
- Coste. Se compone del equipo edge, el chip de IA, las cámaras y una licencia mensual de software por equipo. Un equipo puede evaluar de 1 a 40 cámaras en paralelo.
En nuestro artículo sobre cámaras como sensores explicamos cuándo una cámara es el mejor sensor para una tarea y cuándo no lo es.
Dónde encaja en DBR77 IIoT
Vision AI es la capa de cámaras de DBR77 IIoT. En todo el sistema rigen los mismos principios:
- Nuestros dispositivos solo leen. Nunca envían órdenes a sus máquinas ni modifican el sistema de control.
- Las imágenes se analizan en planta y no se graba vídeo.
- Vision AI funciona sobre DBR77 Vector, nuestra propia IA industrial, que puede instalarse en sus servidores. Sus datos no entrenan ningún modelo sin su consentimiento por escrito, y DBR77 está certificada según la norma ISO/IEC 27001:2022.
- Los eventos de Vision AI llegan a IRIS, junto a los datos de máquina.
Preguntas frecuentes
¿Hay que reunir imágenes antes?
Para entrenar el sistema, no. Para la prueba le pedimos unas cuantas fotos y uno o dos vídeos cortos del puesto y, si hay diferencias sutiles, el equipo marca algunas piezas como OK o NOK para tener un patrón.
¿Quién puede añadir un control nuevo?
Los ingenieros y los técnicos, con el sistema en marcha. Describen con palabras el objeto y cómo es un resultado bueno y uno malo, y fijan la reacción sin programar.
¿Qué pasa cuando la cámara ve algo que nadie ha descrito?
Lo notifica como una desviación aún sin clasificar. Un ingeniero le pone nombre una vez, decide qué debe pasar y, la próxima vez, el sistema la gestiona automáticamente.
¿Funciona con cualquier pieza?
No necesariamente. Las descripciones de texto funcionan peor con detalles finos y piezas poco habituales, así que cada control se prueba primero con fotos de su línea, y el patrón OK/NOK está para las diferencias que las palabras no recogen.
¿Puede un control parar la línea?
No. Un control puede contar, registrar, avisar o notificar a una persona. El sistema no para ninguna máquina: la decisión es de una persona.
Conclusión
Elija un puesto en el que un control se haga todavía a ojo o en papel, y escriba con palabras sencillas qué debe buscar la cámara, cómo es un resultado bueno y cómo es uno malo. Aparte varias piezas OK y NOK y decida quién recibe la notificación cuando algo sale mal. Después, acuerde quién pondrá nombre a las desviaciones que nadie ha descrito. Con eso tiene la base para una primera prueba con fotos y vídeos cortos del puesto.
Traiga a la demo un control de su línea
Descríbalo por escrito. Le enseñamos cómo se introduce, qué resultados da en un ejemplo parecido y qué haría falta en su planta.
Fuentes
- A. Radford et al., Learning Transferable Visual Models From Natural Language Supervision, 2021
- P. Bergmann et al., MVTec AD: A Comprehensive Real-World Dataset for Unsupervised Anomaly Detection, CVPR, 2019
- S. Liu et al., Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection, 2023
- F. Ciaglia et al., Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark, 2022
- L. Bianchi et al., The devil is in the fine-grained details: Evaluating open-vocabulary object detectors for fine-grained understanding, 2023
- S. Baeuerle et al., Are Foundation Models Ready for Industrial Defect Recognition? A Reality Check on Real-World Data, preprint, 2025
- K.J. Joseph et al., Towards Open World Object Detection, CVPR, 2021
- Lean Enterprise Institute, Lean Lexicon, 5th edition, excerpt
- DBR77, DBR77 IIoT, 2026
- DBR77, presentación de IIoT y Vision AI para clientes, 2026