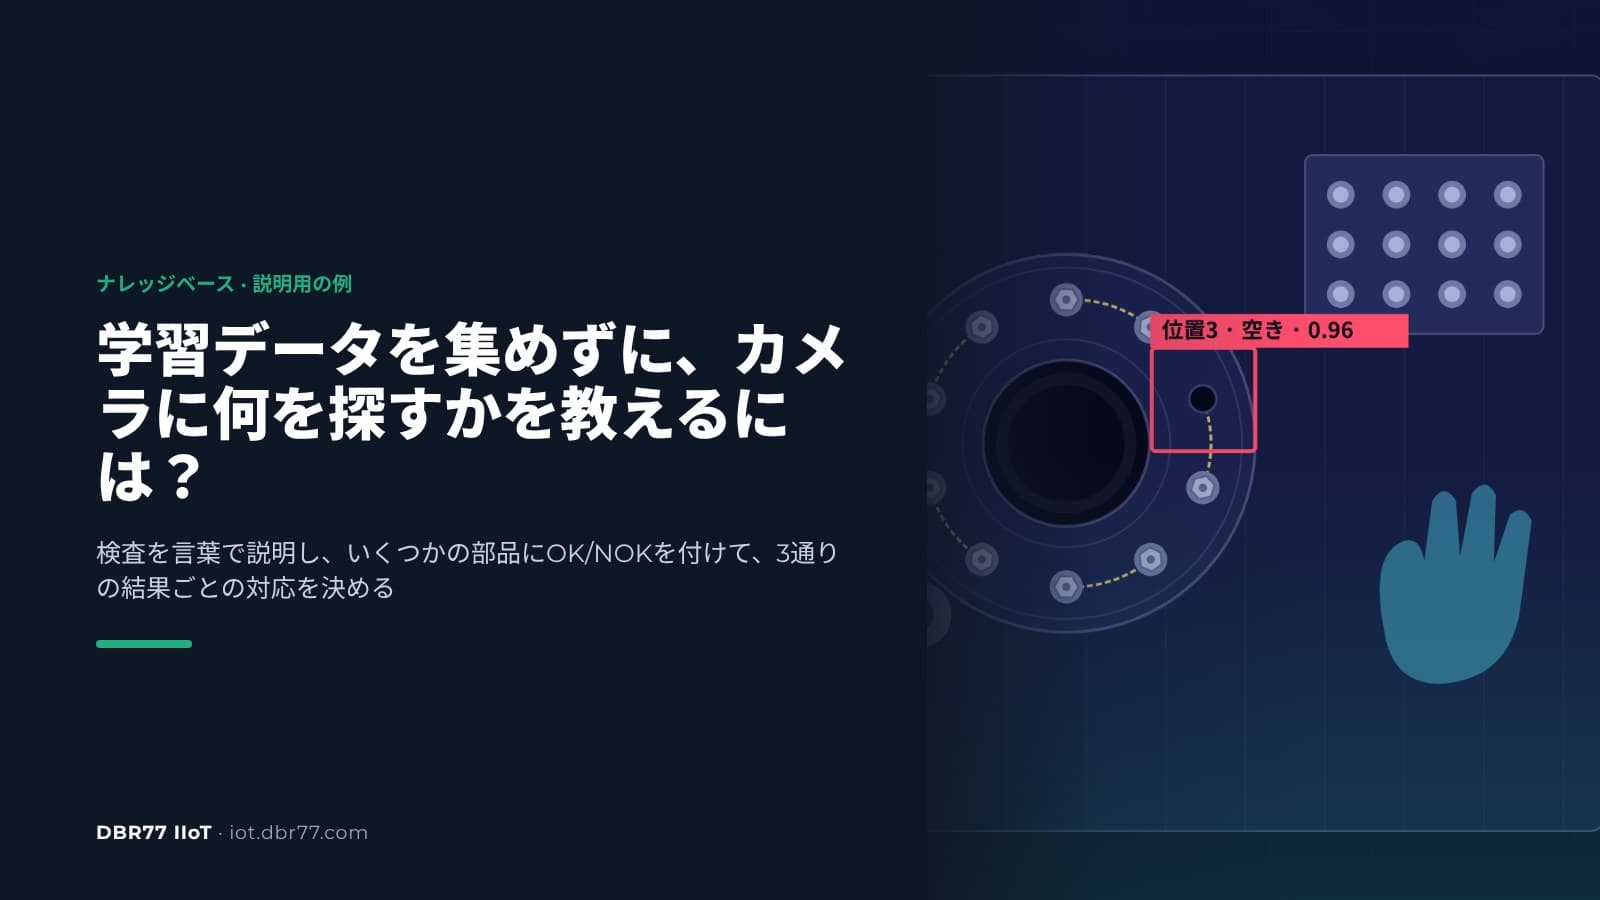
学習データを集めずに、カメラに何を探すかを教えるには?
DBR77 Team · 公開日
何を探すか、良い結果と悪い結果がどう見えるかを言葉で説明すれば、チームでカメラに教えられます。DBR77 IIoTでは、エンジニアが対象(たとえば「フランジAのボルト」)、適合の状態(「全10本装着、セーフティワイヤ付き」)、不適合の状態(「ボルトの欠品・誤品」)を入力します。いくつかの部品にOKかNOKのラベルを付ければ、それが自社の基準品になります。そのあとは、どの場面にも結果が3通りあります。適合、不適合、未分類の異常です。3つ目はまだ誰も説明していないもので、エンジニアが一度だけ名前を付けます。学習データを集める必要も、学習プロジェクトを立ち上げる必要もありません。ただし、どの検査も稼働させる前に、自社ラインの写真でテストしてください。
この記事は、生産現場でのカメラ活用を扱うシリーズの一つです。ほかの記事では、ボルトを1本ずつ基準品と照合する方法と、組立の各手順が正しい順序で行われたかの確認を取り上げています。
従来のマシンビジョンに学習データが必要な理由
ほとんどの画像認識システムは、あらかじめ決めたカテゴリーの一覧を学習します。画像とテキストを結び付けるモデルCLIPの著者らは、この方式の欠点として、ほかの視覚的な概念を扱うたびにラベル付きのデータを追加しなければならず、汎用性と使いやすさが限られることを挙げています。新しい部品、工具、不良が出るたびに、新しい画像とラベルが要ります。
品質検査では、その画像がなかなか集まりません。外観検査の評価に広く使われるデータセットMVTec ADの論文は、工業プロセスは不良品ができるだけ出ないように最適化されていると指摘しています。良いラインほど不良は少なく、不良の種類ごとに十分な例を集めるには時間がかかります。
そのため実際には、最も効果の大きい検査にだけビジョンシステムを入れ、残りは紙のチェックシートのまま、ということがよくあります。
言葉で説明する仕組み
新しい検出モデルでは、決まった一覧の代わりに言葉で対象を指定します。その一例が研究用のモデルGrounding DINOで、カテゴリー名や対象を指す表現など、人が入力した言葉をもとに任意の物体を検出します。こうした手法は、語彙が固定されていないという意味で、オープンボキャブラリ物体検出と呼ばれます。
DBR77 IIoTのVision AIは、この考え方を2つのステップで使います。
- 教える。 エンジニアが場面を説明します。何を探すか、適合と不適合がそれぞれどう見えるかです。細かな違いを見分けるときは、チームがいくつかの部品にOKかNOKのラベルを付け、以後はこの基準品と照合して品質を確認します。
- 見る。 画像を1枚ずつ、教えた内容と照合します。結果は、次の節で説明する3通りのどれかになります。
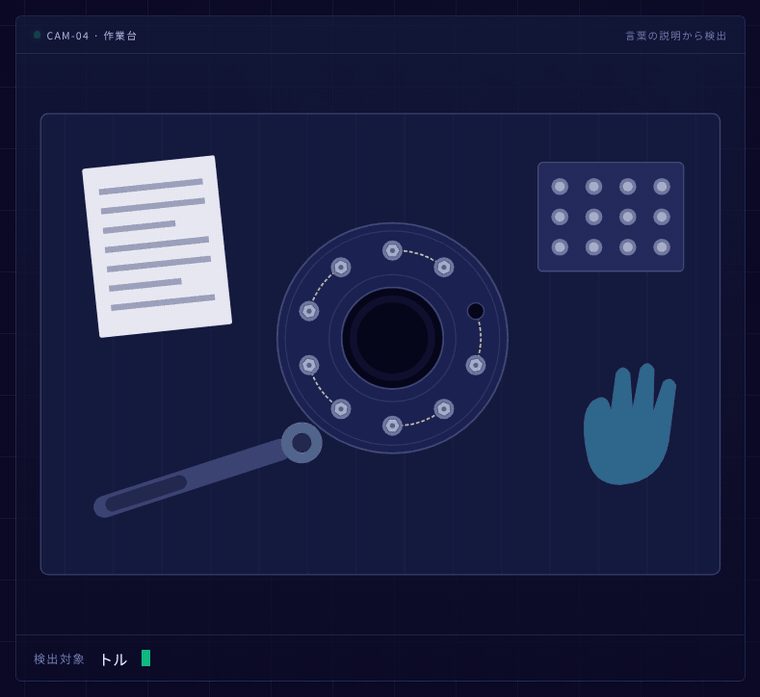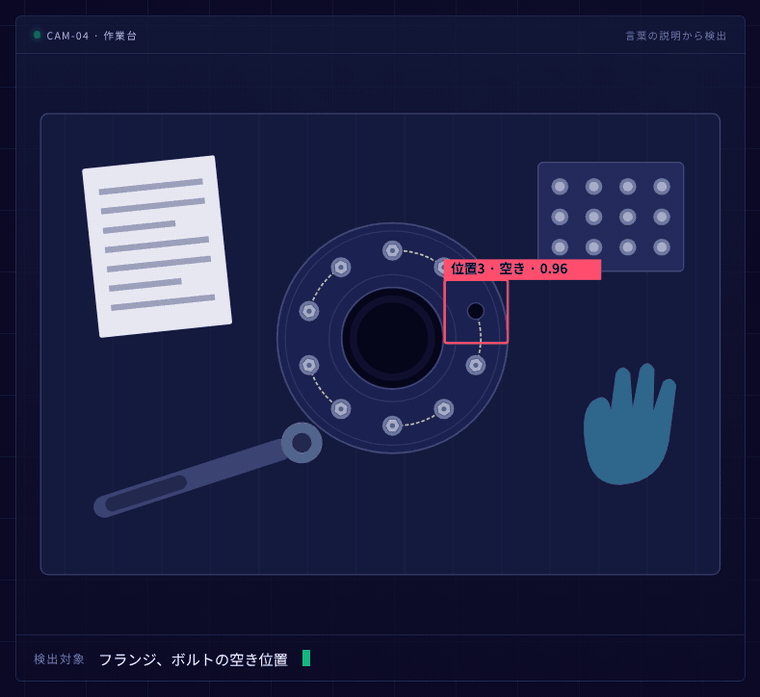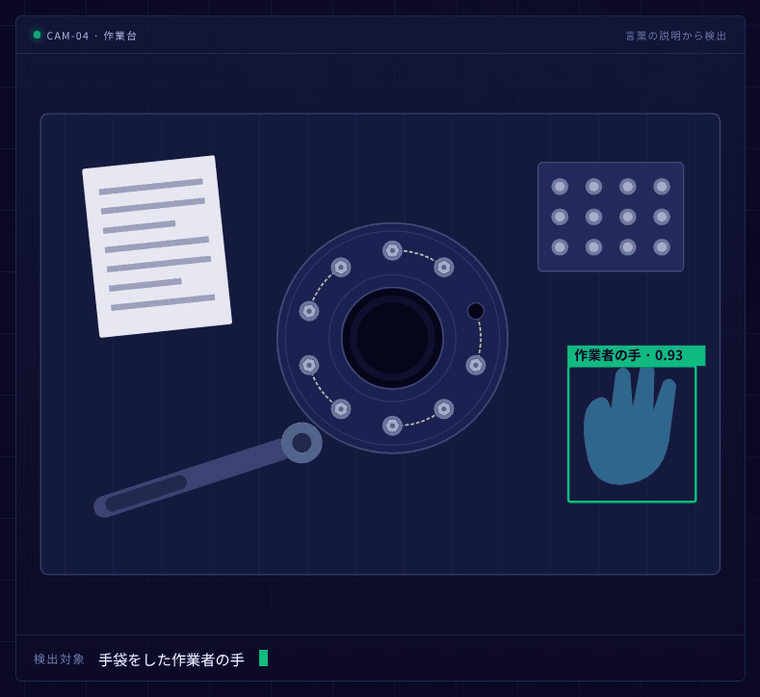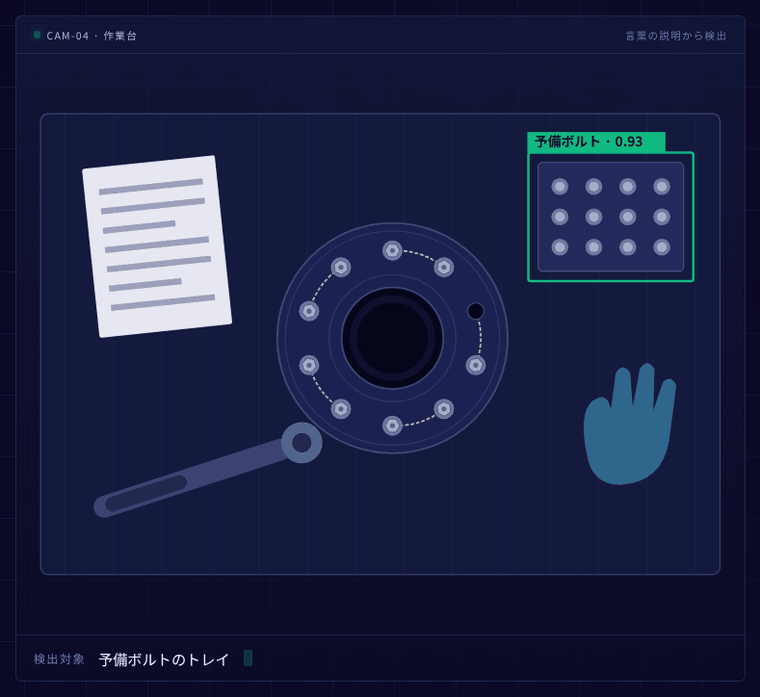
DBR77 Vision AIのプレゼンテーションに基づく説明用の例。言葉で説明するたびに、その物体が枠で囲まれます。
この説明用の例では、カメラが作業台を映しています。エンジニアが「トルクレンチ」「予備ボルトのトレイ」「フランジ、ボルトの空き位置」「作業手順書」「手袋をした作業者の手」と入力します。入力するたびにその物体が枠で囲まれ、ボルトの空き位置は赤で示されます。
新しい検査は、エンジニアや作業者が稼働中に追加できます。ラインに新しい部品や工具が入ったら、それを言葉で説明すれば、カメラはその時点から探し始めます。
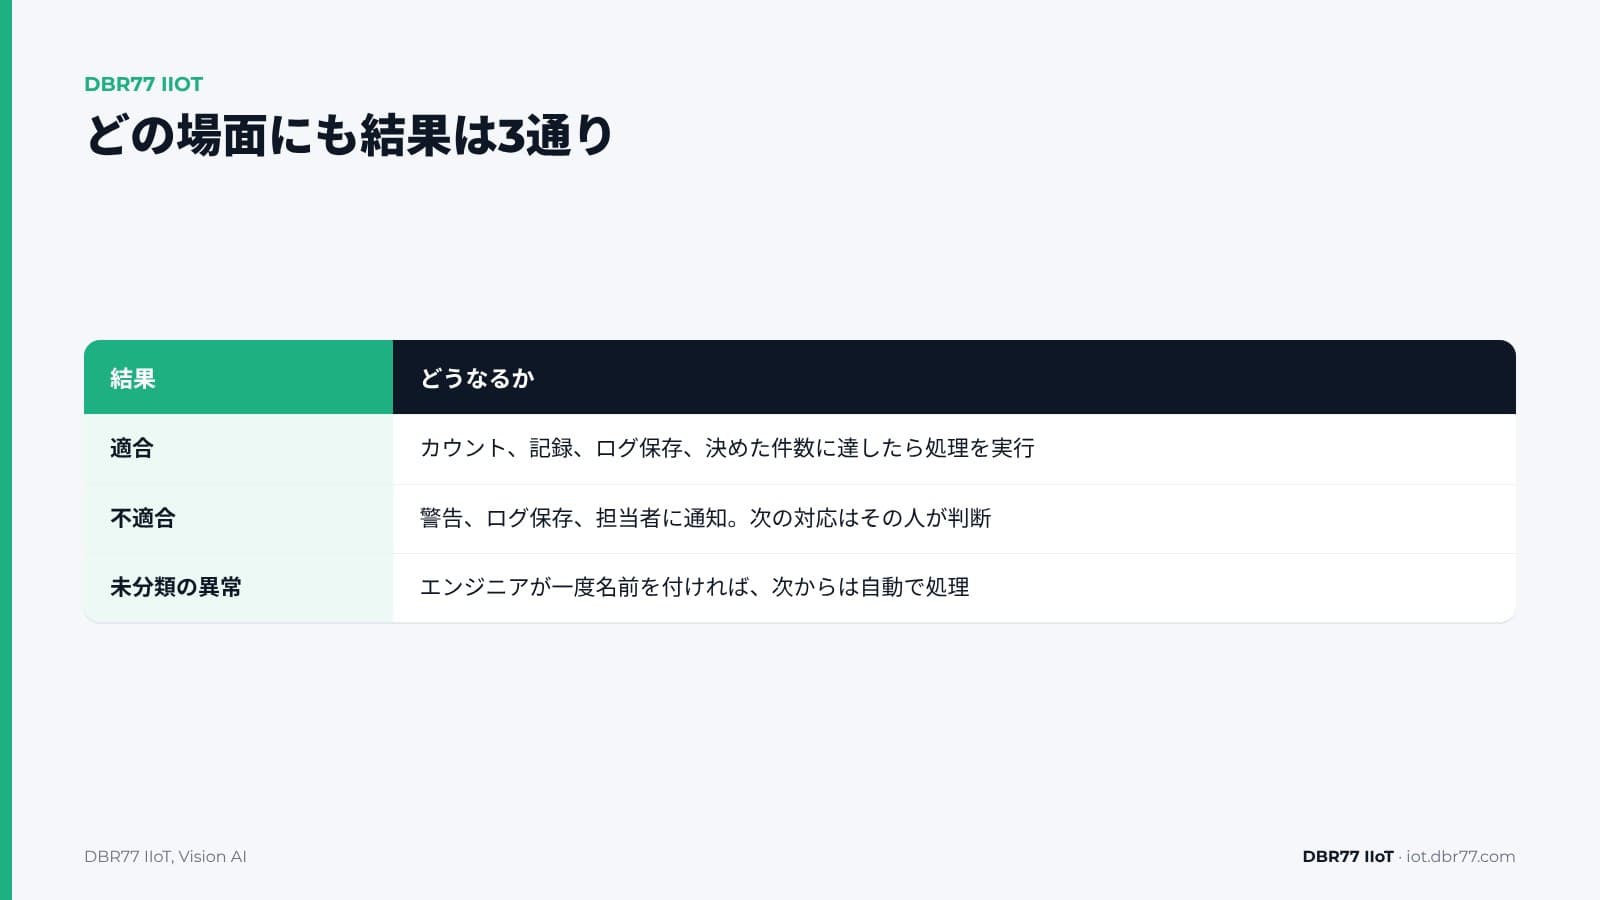
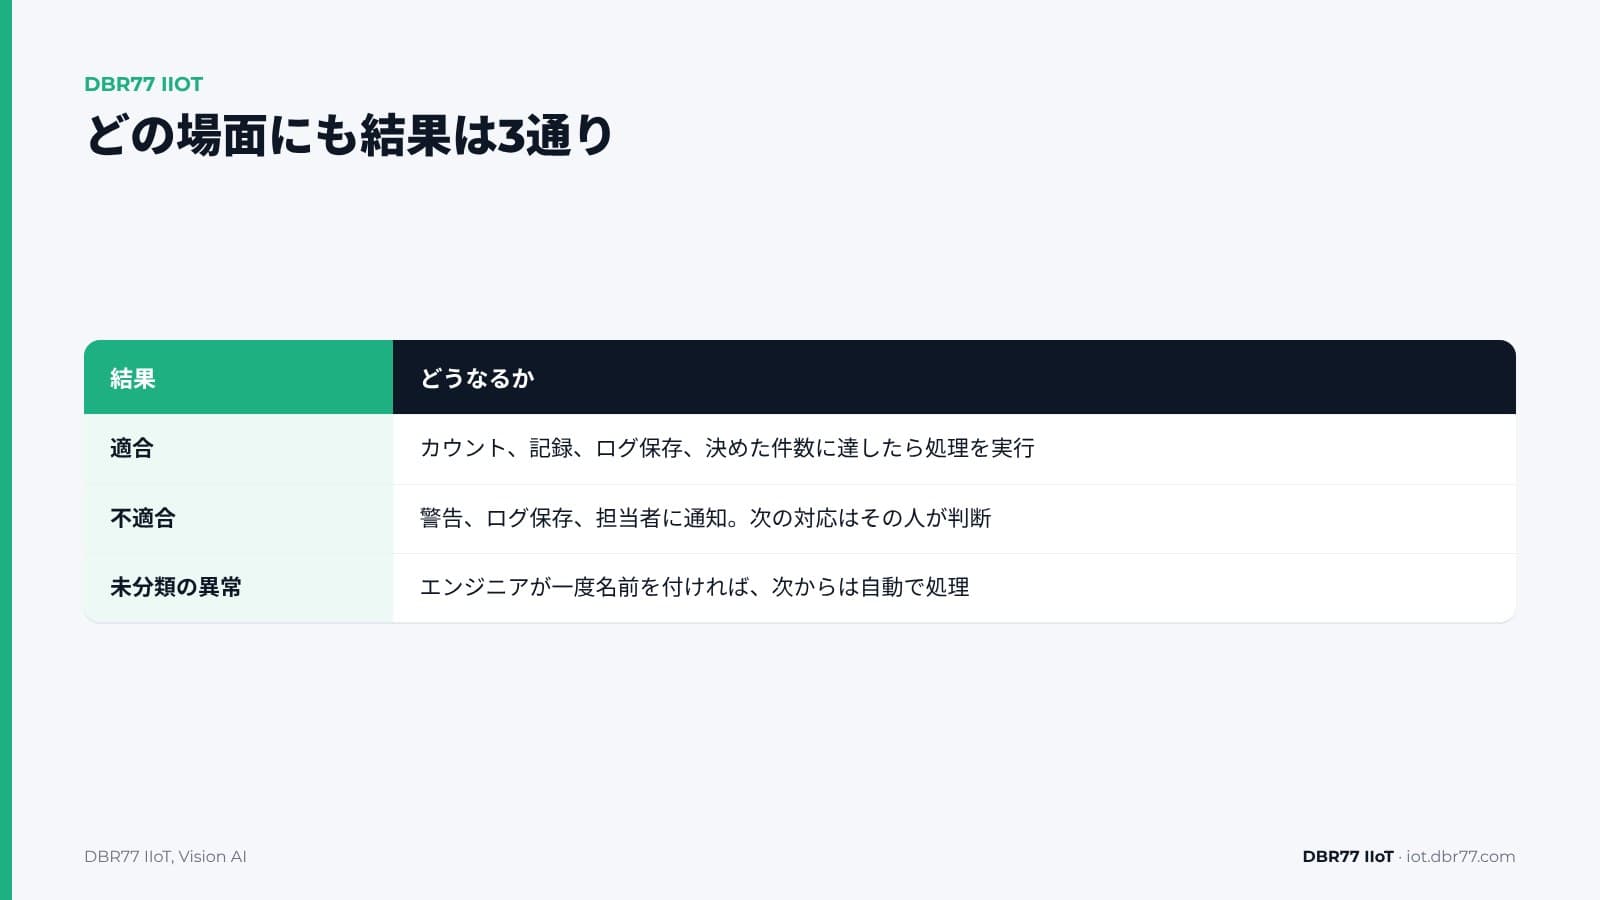
どの場面にも結果は3通り
検査の結果は3通りあり、それぞれで何をするかはチームが決めます。
- 適合。 システムがカウントして記録し、ログに残します。決めた件数に達したら、次の処理を実行することもできます。たとえば、ボルト7の装着を確認し、10本すべてそろったら、チームが設定した処理(「フランジA完了」のメッセージなど)に進みます。
- 不適合。 システムが警告し、ログに残し、担当者に通知します。たとえば位置4のボルトの種類が違えば、その箇所を示した画像が作業者に届きます。システムが設備を止めることはなく、次にどうするかは人が判断します。
- 未分類の異常。 まだ誰も説明していないものが写った場合です。たとえば、フランジの上に見慣れない物が置かれているときです。エンジニアが一度名前を付けると、対応を決めた新しいカテゴリーになり、次からは自動で認識され、処理されます。新しいカテゴリーは、ステップ1で教えた内容に加わります。
| 結果 | どうなるか |
|---|---|
| 適合 | カウント、記録、ログ保存、決めた件数に達したら処理を実行 |
| 不適合 | 警告、ログ保存、担当者に通知。次の対応はその人が判断 |
| 未分類の異常 | エンジニアが一度名前を付ければ、次からは自動で処理 |
システムを最新の状態に保つのは、3つ目の結果です。研究にも、オープンワールド物体検出という似た考え方があります。検出器は教わっていない物体を「未知」として示し、未知の物体のうち注目すべきものには、オラクル(正解を与える役)がラベルを付けます。現場でこの役を担うのは、自社のエンジニアです。
自社ラインの検査を1つ、言葉で説明してみる
工程の写真を数枚と、短い動画を1〜2本お送りください。撮影は社内の撮影ルールに従ってください。あわせて、何を探すかを言葉で教えてください。システムが何を見つけ、何を見逃すかをお見せします。
言葉による説明の限界
言葉による説明が最もうまくいくのは、見た目が言葉どおりの物体です。研究では、弱点が2つ指摘されています。
1つ目は、新しい分野です。さまざまな分野の100のデータセットを集めたベンチマークでは、ゼロショット物体検出モデルは新しい分野に広げると性能が大きく落ちることが分かりました。独自の部品、照明、撮影角度がある工場の現場も、そうした新しい分野に当たることがあります。
2つ目は、細かな特徴です。2023年の研究によると、オープンボキャブラリ物体検出器は、色、模様、材質といった物体の細かな特徴を正確にとらえて区別するのが苦手です。2025年のプレプリントは、さらに踏み込んでいます。この研究では、最新の基盤モデルにテキストプロンプトを与え、量産ラインで撮った実際の工業画像で試しました。どのモデルも公開ベンチマークでは良い成績を出しますが、著者らは自分たちの実データではすべて失敗したと書いています。
そのため、言葉で説明するのは最初の一歩にすぎません。説明だけで足りるところは、自社の写真でのテストで分かります。セーフティワイヤが付いているか、付いていないかのような細かな違いにはOK/NOKの基準品を使い、それで足りるかもテストで確かめます。カメラが気付いたのに誰も説明していない異常は、3つ目の結果として示されます。
ルールと対応は誰が決めるか
検査は、誰かがその結果に応じて動いて初めて役に立ちます。リーンでは昔から、これは現場の仕事とされてきました。アンドンは異常が起きるたびに知らせ、班長が対応します。Vision AIでも、検査を設定し、対応を決めるのは、その工程をよく知る現場の人たちです。
最初の検査を稼働させる前に、次のことを決めておいてください。
- 検査を追加できる人。 たとえば、生産技術者と、シフトの作業リーダーです。
- 新しいカテゴリーの名前の付け方。 ラインの誰もが分かる短い名前にし、1か所にまとめて書いておきます。
- 3つ目の結果を確認する人。 未分類の異常がたまらないよう、毎シフトか毎週、誰かが目を通します。
- どの通知を誰が受け取るか。 アラートが多すぎると、人は無視するようになります。これについては記事現場で設備アラートが機能しない理由で取り上げています。
1つの工程で試すには
テストの進め方は、ほかのVision AIの検査と同じです。デモと対象工程の確認、NDAを結んだうえでの数枚の写真と短い動画によるテスト、1工程でのPoC(概念実証)と進み、結果にご納得いただけた場合にだけ横展開します。
- カメラ。 一般的なIPカメラを使えます。画像1枚の解析にかかる時間は約25ミリ秒で、解析は工場内に置いたコンピューターで行います。
- 定義。 何を探すか、何を良い結果、何を悪い結果とするかをエンジニアが言葉で入力し、稼働中でもチームが新しい検査を追加できます。学習データを集める必要はなく、学習プロジェクトを立ち上げることもありません。
- 対応。 何をするかは自社で決めます。カウント、ログへの記録、警告、担当者への通知を、プログラミングなしで設定できます。システムが設備を止めることはなく、判断するのは人です。
- 費用。 エッジ機器、AIチップ、カメラ、そしてエッジ機器1台ごとの月額ソフトウェアライセンスからなります。1台のエッジ機器で1〜40台のカメラを並行して解析できます。
どんなときにカメラがセンサーより向いているか、向いていないかは、記事センサーとしてのカメラで解説しています。
DBR77 IIoTの中での位置付け
Vision AIは、DBR77 IIoTでカメラを担う部分です。システム全体で同じ原則が当てはまります。
- 当社の機器はデータを読み取るだけです。設備に指令を送ることはなく、制御システムにも手を加えません。
- 画像は工場内で解析し、映像は録画しません。
- Vision AIは、お客様のサーバーにも導入できるDBR77独自の産業用AI、DBR77 Vectorの上で動きます。書面による同意がない限り、お客様のデータをモデルの学習に使うことはありません。DBR77はISO/IEC 27001:2022の認証を取得しています。
- Vision AIのイベントは、設備データと一緒にIRISに記録されます。
よくある質問
先に画像を集める必要がありますか?
学習のためには必要ありません。テストには、工程の写真を数枚と短い動画を1〜2本お願いしています。細かな違いを見分けるときは、チームがいくつかの部品にOKかNOKのラベルを付け、基準品にします。
新しい検査は誰が追加できますか?
エンジニアや作業者が、稼働中に追加できます。対象と良い結果・悪い結果を言葉で説明し、対応はプログラミングなしで設定します。
誰も説明していないものをカメラが見つけたらどうなりますか?
未分類の異常として報告されます。エンジニアが一度名前を付けて対応を決めれば、次からは自動で処理されます。
どんな部品にも使えますか?
どの部品でもそのまま使えるわけではありません。言葉による説明は、細かな特徴や珍しい部品が苦手です。そのため、どの検査もまず自社ラインの写真でテストし、言葉では伝えきれない違いにはOK/NOKの基準品を使います。
検査でラインを止められますか?
いいえ。検査でできるのは、カウント、ログへの記録、警告、担当者への通知です。システムが設備を止めることはなく、判断するのは人です。
まとめ
目視や紙で検査している工程を1つ選び、カメラが何を探すか、良い結果と悪い結果がどう見えるかを、普段の言葉で書き出してください。OK品とNOK品をいくつか用意し、問題が起きたときの通知先もはっきりさせておきます。そのうえで、誰も説明していない異常に誰が名前を付けるかを決めてください。これで、工程の写真と短い動画を使った最初のテストの準備が整います。
出典
- A. Radford ほか, Learning Transferable Visual Models From Natural Language Supervision, 2021
- P. Bergmann ほか, MVTec AD: A Comprehensive Real-World Dataset for Unsupervised Anomaly Detection, CVPR, 2019
- S. Liu ほか, Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection, 2023
- F. Ciaglia ほか, Roboflow 100: A Rich, Multi-Domain Object Detection Benchmark, 2022
- L. Bianchi ほか, The devil is in the fine-grained details: Evaluating open-vocabulary object detectors for fine-grained understanding, 2023
- S. Baeuerle ほか, Are Foundation Models Ready for Industrial Defect Recognition? A Reality Check on Real-World Data, プレプリント, 2025
- K.J. Joseph ほか, Towards Open World Object Detection, CVPR, 2021
- Lean Enterprise Institute, Lean Lexicon, 5th edition, excerpt
- DBR77, DBR77 IIoT, 2026
- DBR77, IIoTおよびVision AIの顧客向けプレゼンテーション, 2026